每日文摘
翻译 · AI 编码让 CI 成了瓶颈,所以我们重构了自己的 CI
翻译转载声明
- 原文:AI coding has made CI a bottleneck, so we reworked ours to keep up
- 作者:Mufeez Amjad(Linear)
- 发布于 2026-09-21
- 本文为忠实中文翻译,图片保留原文原图,版权归原作者所有。
今年早些时候,我打开 Linear,发现我们的 CTO Tuomas 给我派了一个 issue,标题是「CI costs are high」(CI 成本很高)。顺带地,他还希望我把 CI 提速。
Agent 让发布代码的速度呈指数级提升,但验证这些变更的速度却没有跟上同样的节奏。每个 PR 仍然必须经过 CI,所以随着开发加速,CI 成了瓶颈:基础设施成本被推高,开发者和 agent 等待反馈的时间也越来越长。
在让 Linear 的 CI 更高性能的追求中,我们优化的目标是:一个 PR 在 CI 上等待多久,以及它消耗多少 runner 时间。尽管自年初以来我们的测试套件几乎翻了四倍,我们还是把 PR 等待时间从 6 分钟以上降到了 5 分钟出头,同时把每个测试的 runner 时间大约砍了一半。
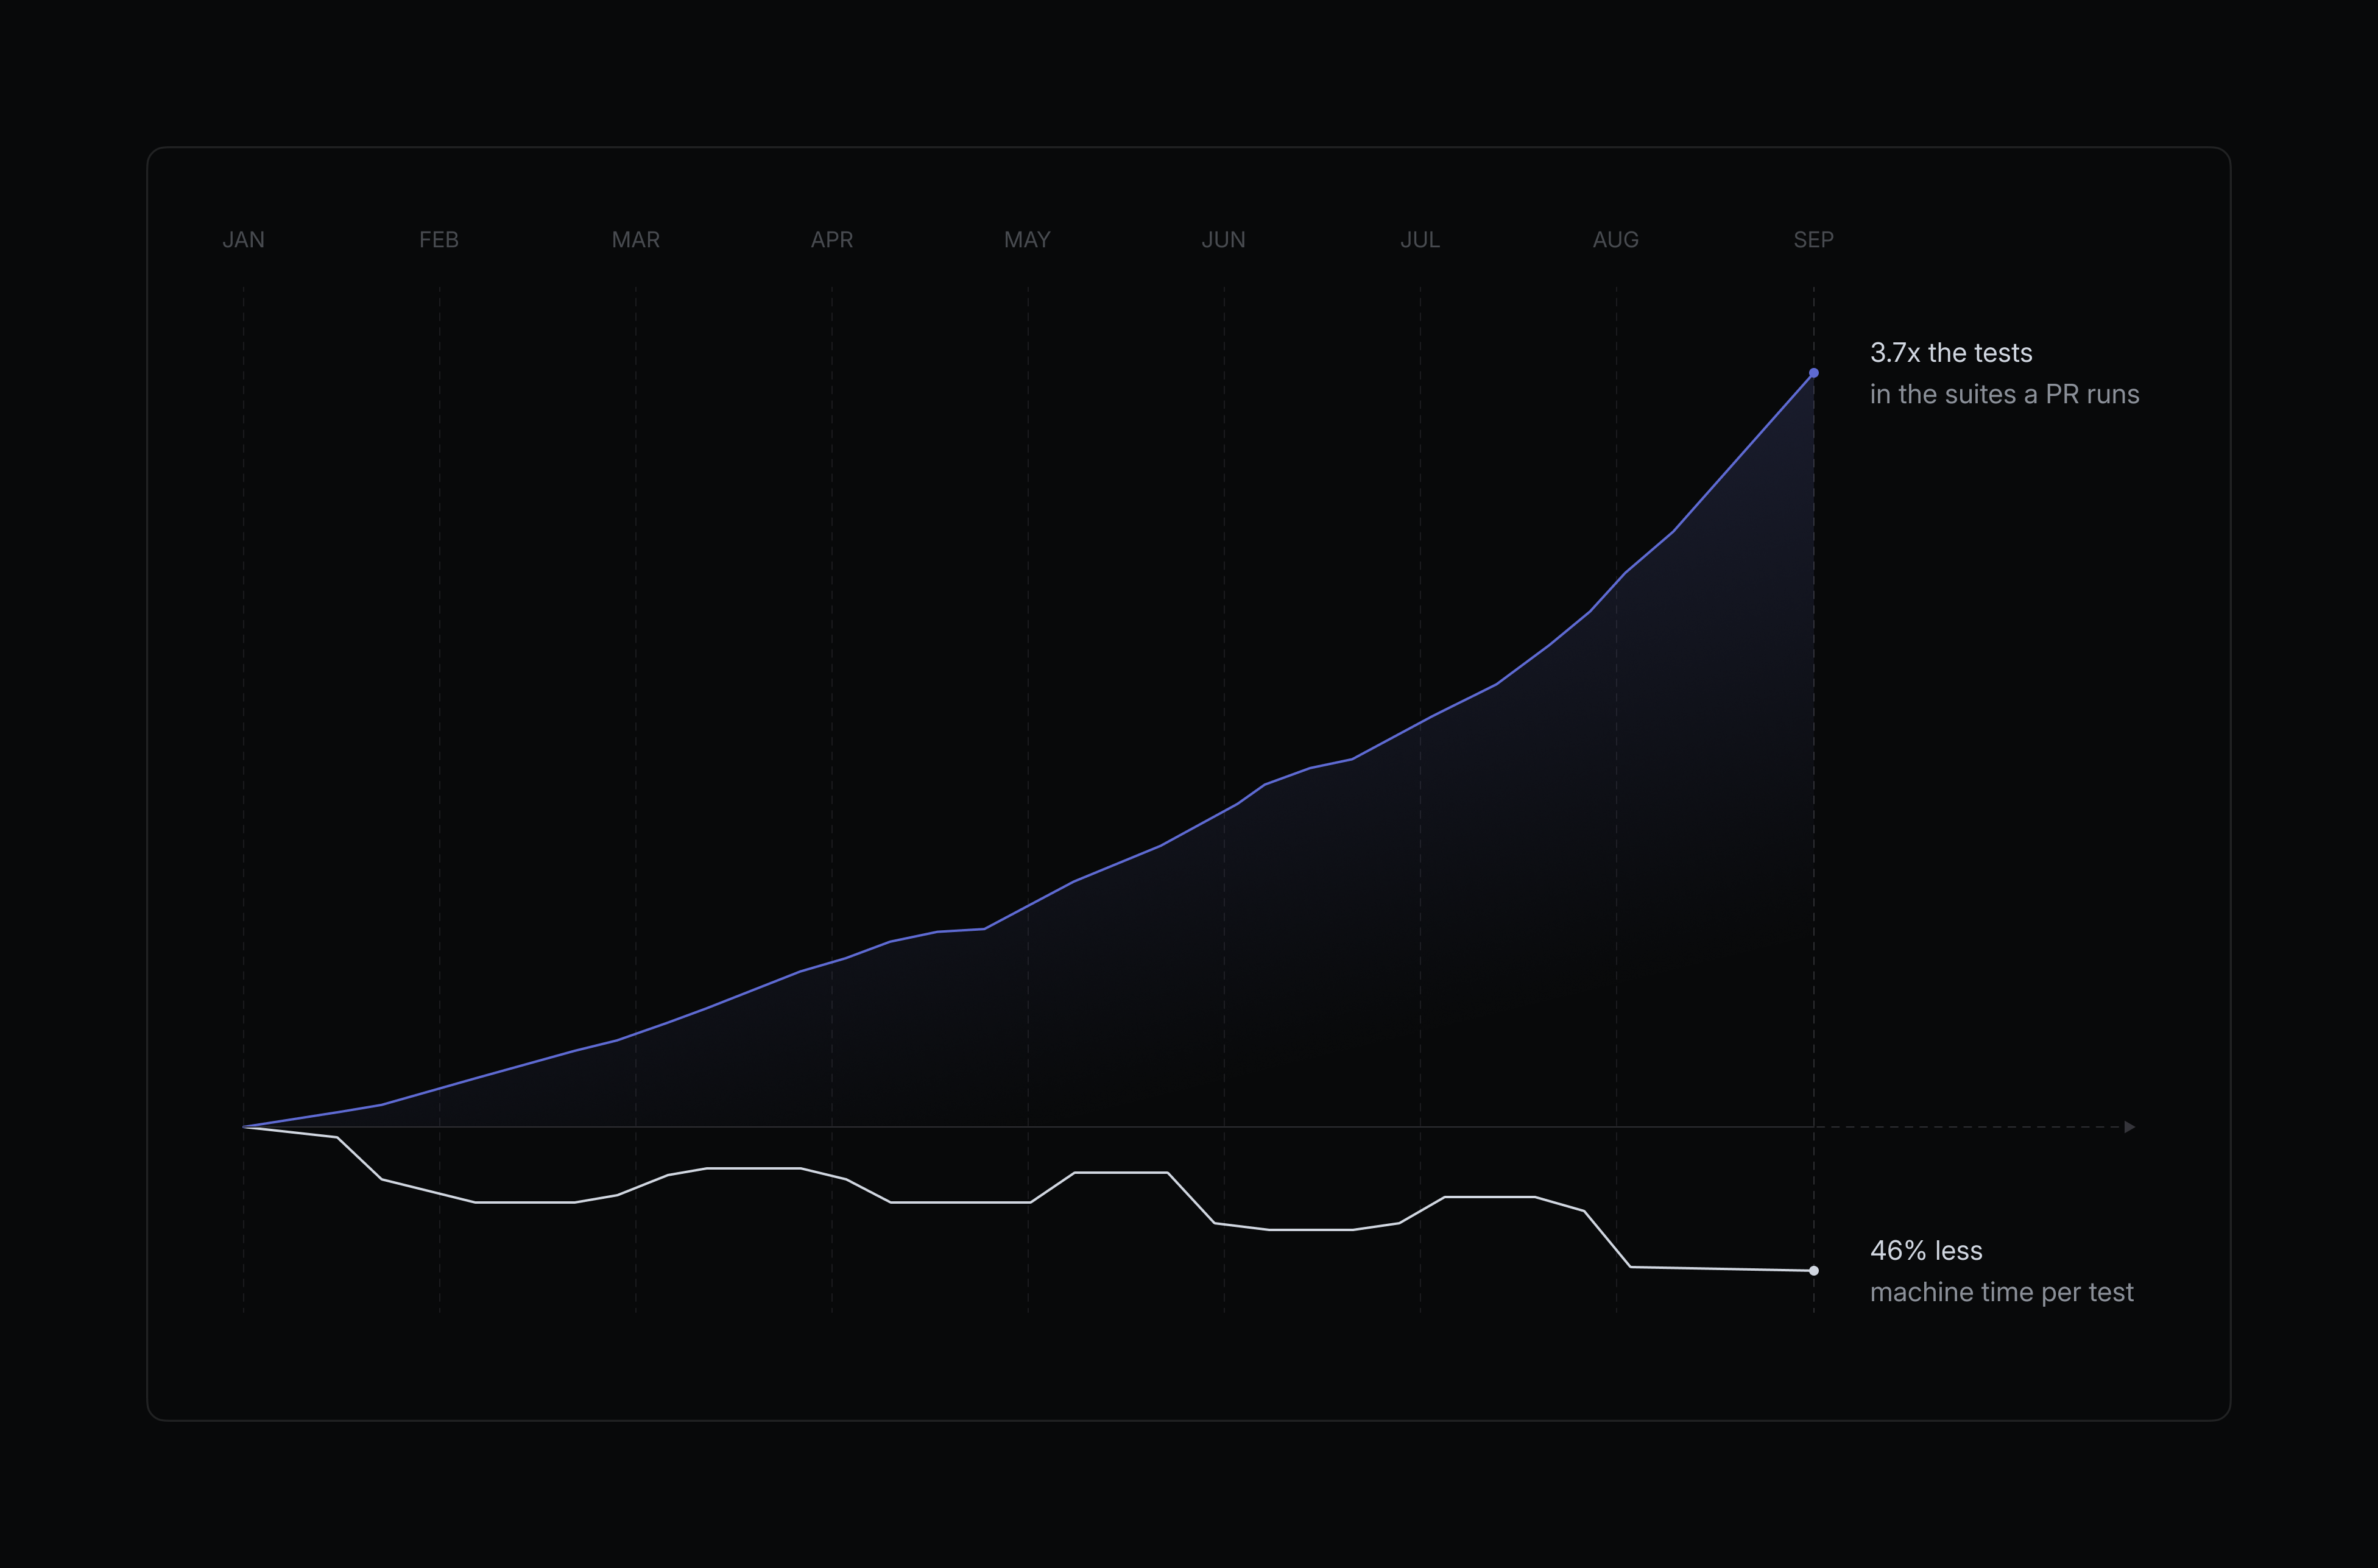
这是以 1 月第一周为基准(指数化)的测试套件性能。追踪每个测试机器时间的白线,在我们添加测试分片时出现尖峰——分片缩短了等待时间,但消耗更多机器时间——在 checkout 卡顿问题期间也再次出现尖峰。
总体上,我们从四个方向改进了 CI:
- 升级基础设施与工具链
- 优化阻塞其他工作的门控 job
- 减少重复 setup
- 让测试执行更高效
Linear 的代码库以 TypeScript 为主,但这些优化大多也适用于其他语言和工具链。
升级基础设施与工具链
最早的一批收益几乎不需要对 CI 本身做任何优化。我们把工作负载从 GitHub Actions 迁到拥有更快 CPU、更高性能存储和更好缓存基础设施的第三方 runner,等于用更快的机器跑同一条流水线。以切换前后各两天的同等对比来看,job 平均快了 34%,tsc 这类负载更是下降了 52%。
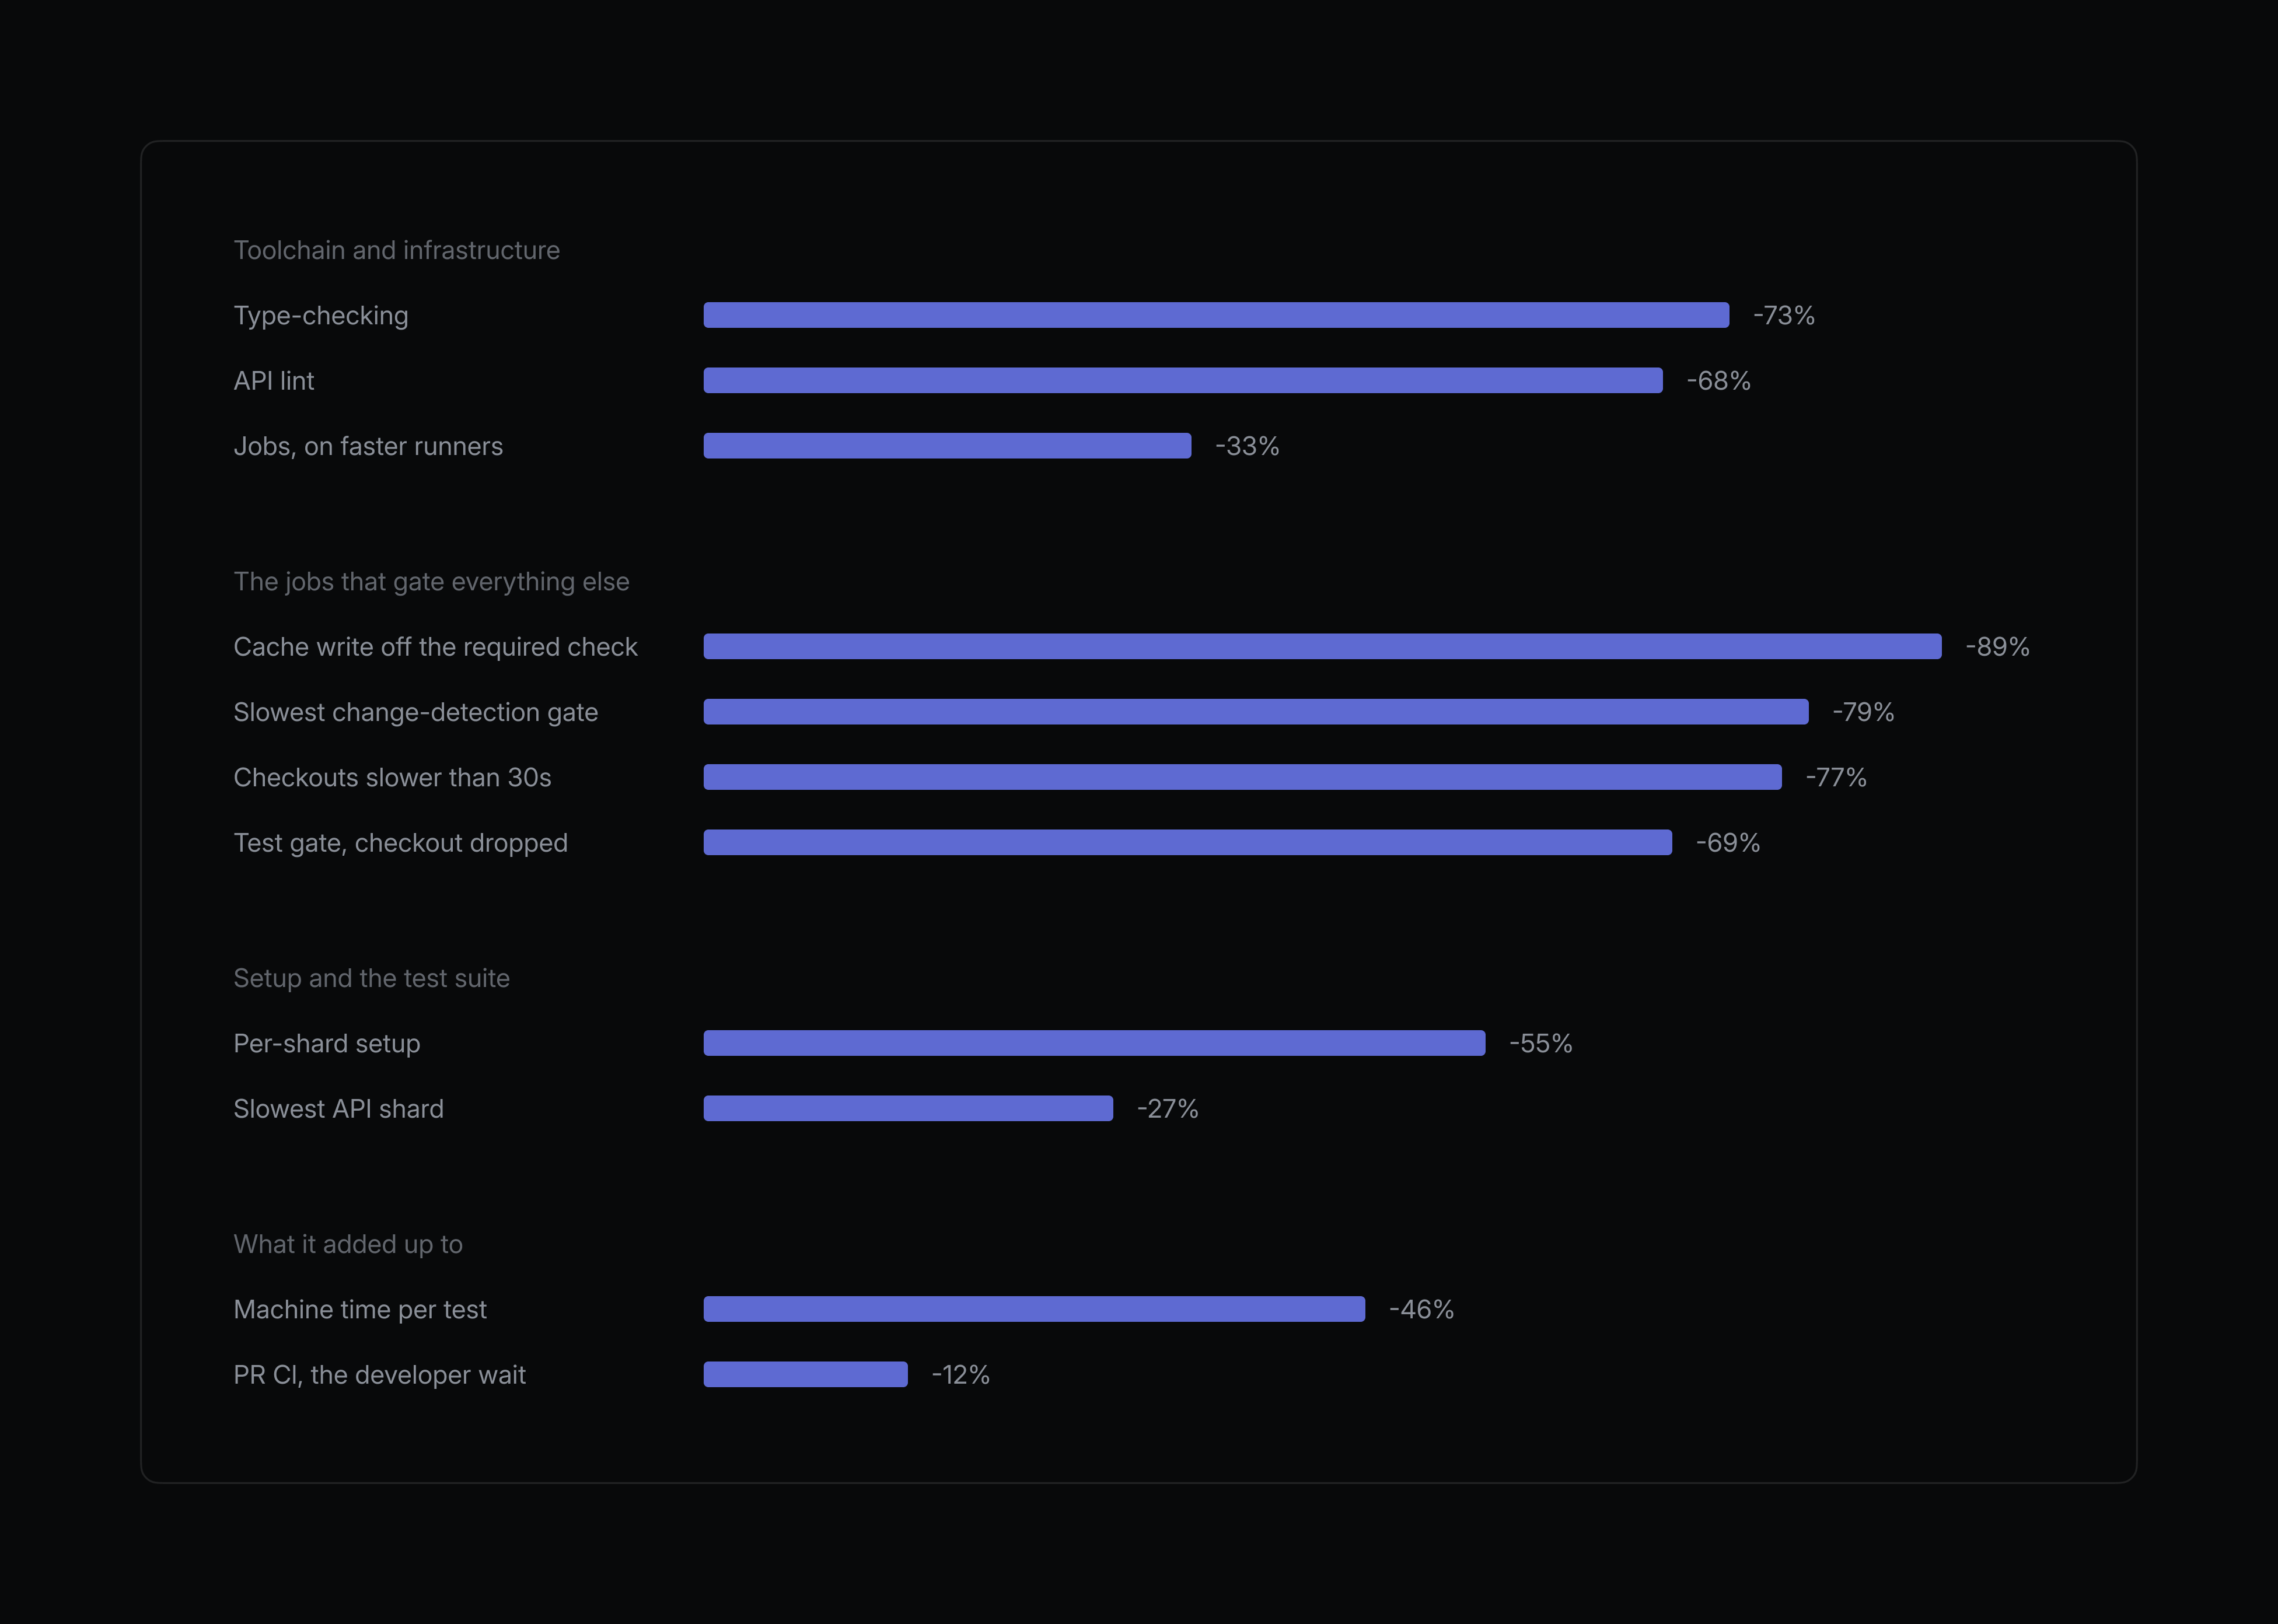
另外,工具链的现代化也同样有回报。切换到原生 TypeScript 编译器 tsgo 后,tsc 检查的周中位数下降了 73%——幅度大到把瓶颈从类型检查上彻底移走。
不带类型检查器的 Lint
Lint 是另一个早期目标。我们有少量自定义 lint 规则依赖 TypeScript 类型信息——或是为了强制执行某条限制,或是为了应用自动修复。这意味着每次 lint 都必须先构建完整的类型图才能评估这些规则,使 lint 成为最吃内存的 CI job 之一。
我们把这些规则重写为对抽象语法树(AST)做静态分析,在不需要类型信息的情况下识别类函数结构和守卫模式。这让 ESLint 彻底甩掉了 TypeScript:API lint 时间减少 68%,全仓 lint 时间减少 55%,内存占用也大幅下降。
摆脱对类型信息的依赖,也让我们后来迁移到 Oxlint 容易得多——纯基于语法操作的规则移植起来很直接。Oxlint 本身也降低了 lint 消耗的 CI runner 分钟数。
优化阻塞其他工作的 job
在底层基础设施和单个检查都变快之后,我们把镜头拉远,把 CI 当作一个系统来看。这让我们注意到那些排在所有工作前面的小 job。每次运行都以检查「PR 改动了哪些路径」「这些测试是否已对相同输入跑过并通过」开始。我们在 job 层面对这些检查设门(gate),让被跳过的工作绝不占用 runner——但这也把它们直接放上了关键路径。这 8 个 API 测试分片中,任何一个都必须等它们结束才能开始,因此哪怕很小的延迟也会被不成比例地放大。
每个 job 只拉取它需要的内容
我们的若干工作流以一个「变更检测」job 开场,由它决定接下来跑什么;例如,它会检查 diff 中是否包含数据库迁移,并输出一个信号用于调度相应的数据库 CI 检查。这些 job 过去会 checkout 完整工作树,尽管它们只需要其中很小一部分。我们限制了 fetch depth,把这类门控中最慢的一个从 94 秒降到 20 秒;对那些从不需要工作树的 job,我们干脆移除了 checkout,把时间从 27 秒降到 7 秒。对于 commit push 和 merge-queue 事件——我们确实需要 diff 路径——我们发现用带有限历史的 sparse、blobless checkout 就够了,又省下大约 11 秒。
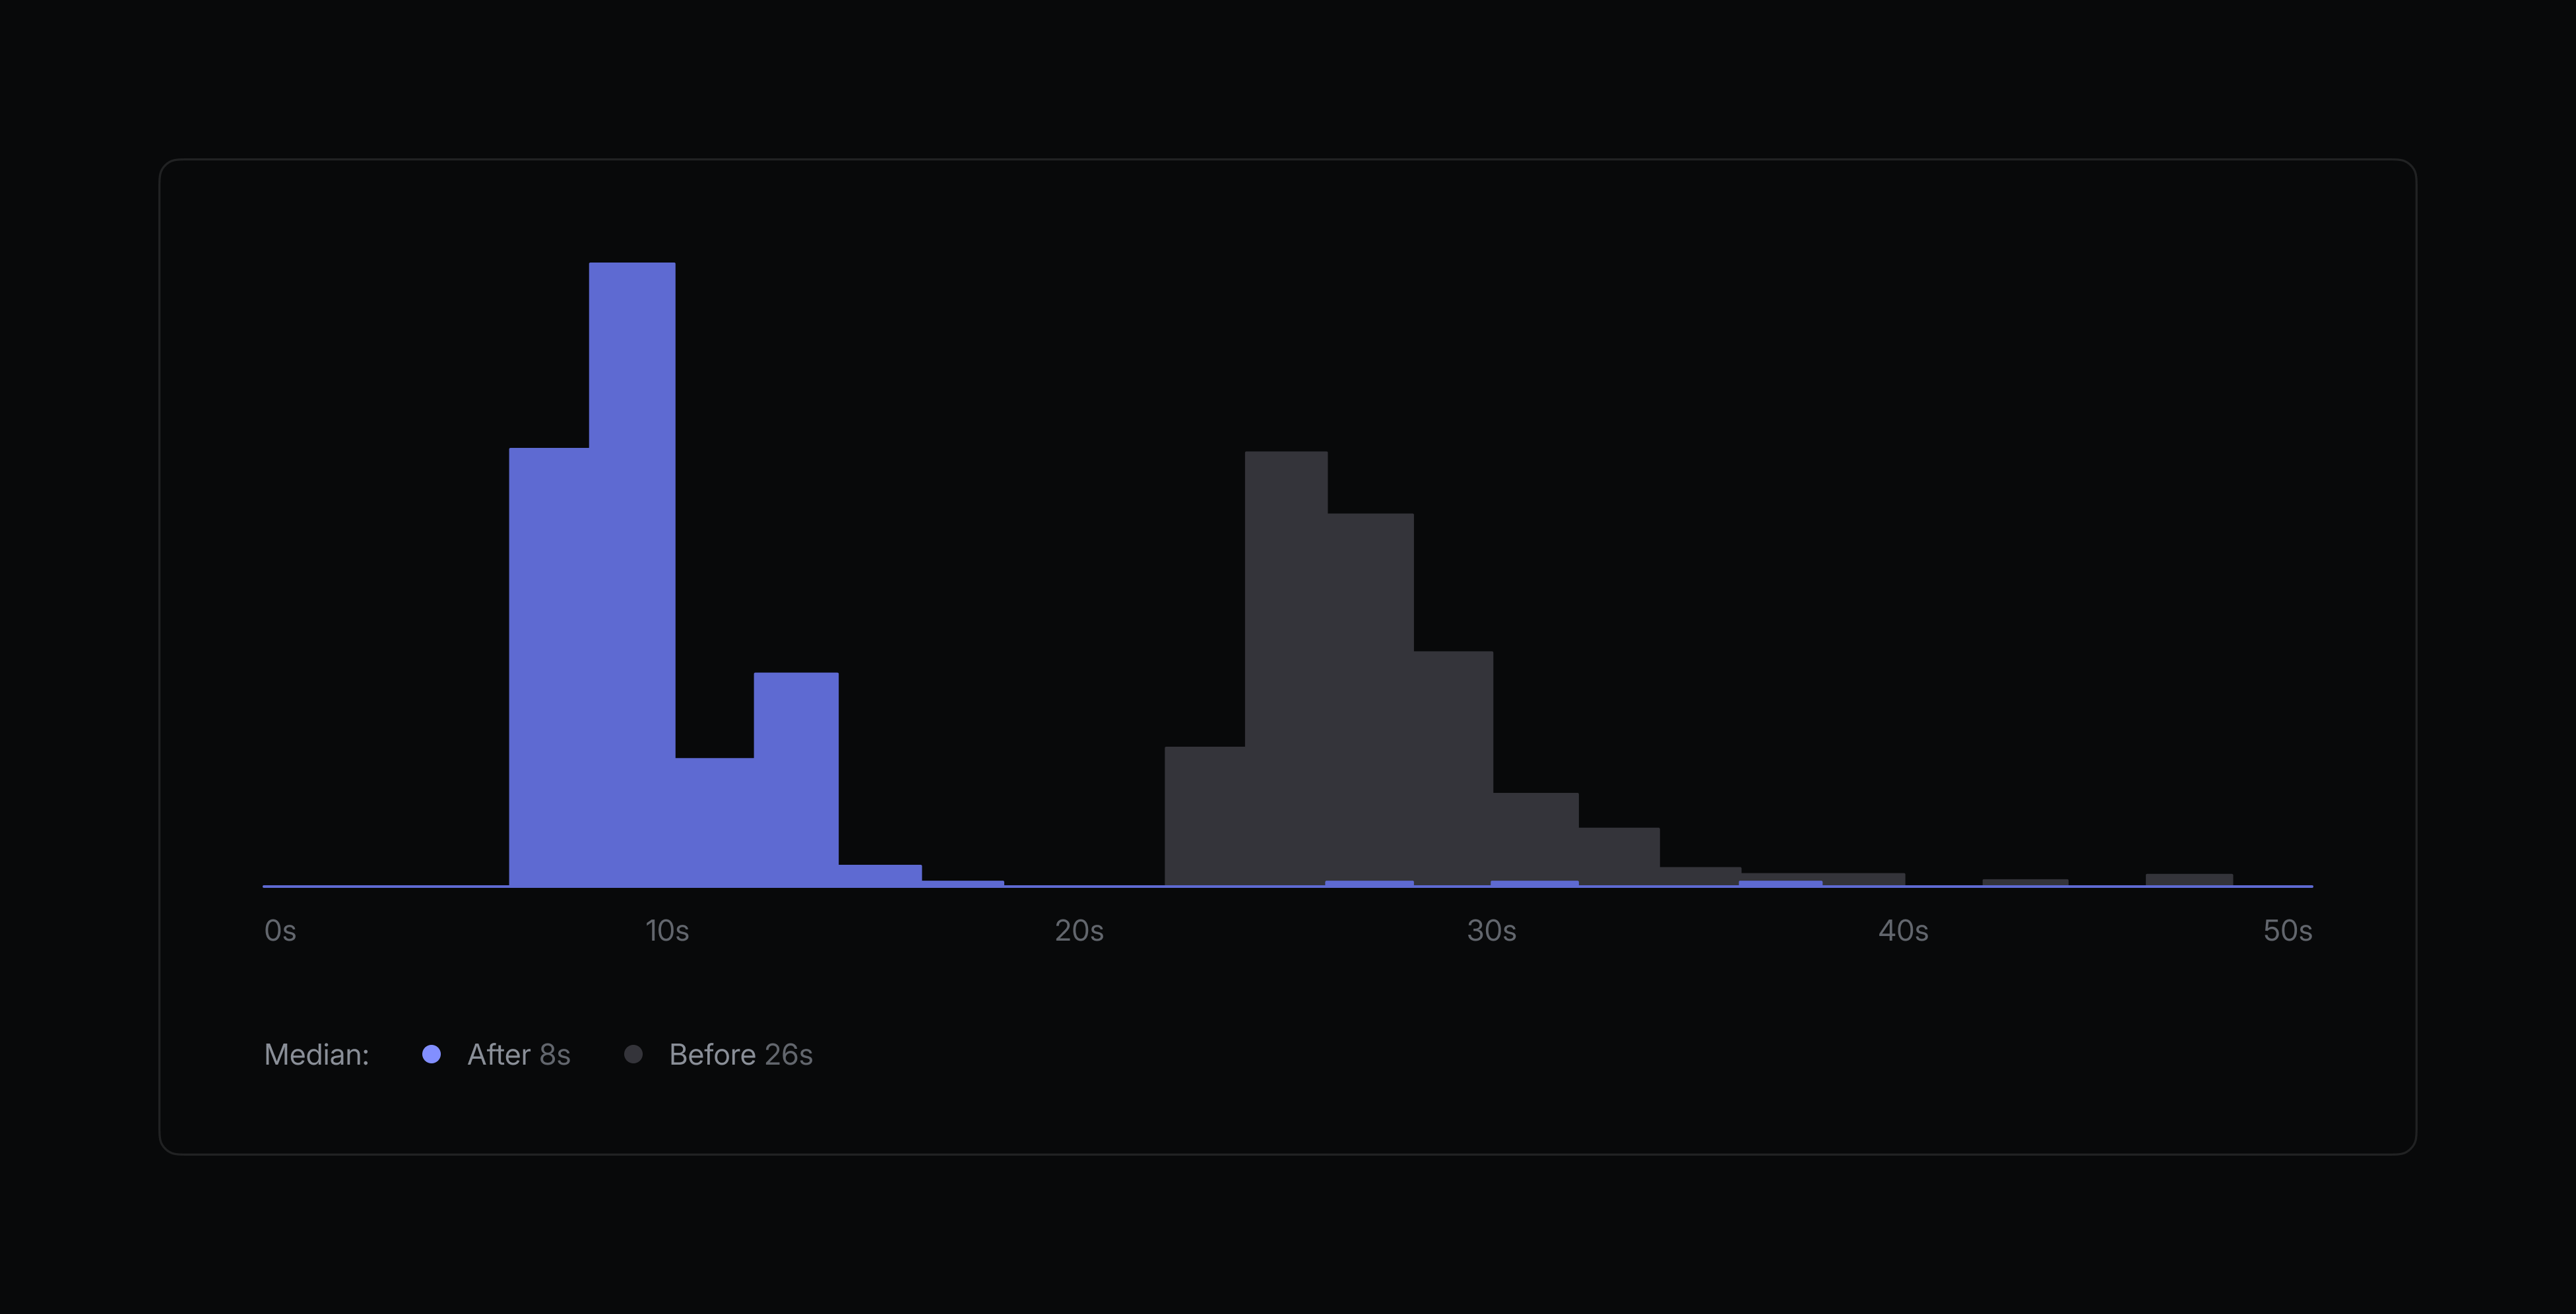
变更检测 job 的中位耗时从 26 秒降到 8 秒,p90 从 31 秒降到 12 秒,最慢的一次运行从 138 秒降到 37 秒。
让 checkout 更有韧性
在更换底层 runner 基础设施之后,我们注意到 job 里的 checkout(用 actions/checkout)变慢了,有时还会挂起。由于第三方 runner 位于 GitHub 网络之外,它们要靠一条直连 IP 链路访问 GitHub。服务商把挂起追踪到这条链路上的间歇性劣化。我们有几个工作流以 checkout 开场,所以一次停滞的 fetch 可能拖慢整个 CI 运行。
为了对网络不稳定保持韧性,我们用一个自建的 composite action 替换了 actions/checkout:它带回退的重试;设置 GIT_HTTP_LOW_SPEED_LIMIT 和 GIT_HTTP_LOW_SPEED_TIME,让停滞的连接在大约 30 秒后中止而不是一直挂着;并使用 checkout 缓存——在 sticky 磁盘上维护一个持久的 git 镜像。结果是,关键路径 job 空等 checkout 完成的运行大大减少。
最小化关键路径上的内容
并不是关键路径上的每个 job 都必须待在那里。我们过去把缓存标记的写入放在合并前的最终检查里,这意味着一个 PR 即使测试已经全部通过,也可能仍卡在 merge queue 里。我们把这次写入移到一个在测试分片结束后运行、但什么都不阻塞的 job 里,为每个 API PR 和 merge-queue 条目从合并路径上砍掉 42 秒。
这些改动加起来,把缓存未命中场景下 API PR 必需检查的时间缩短了大约 1 分钟,同时也减少了 runner 启动次数。
减少重复 setup
接下来,我们把注意力转向每个 job 都要重复支付的 setup 成本,比如启动 runner、安装包、准备构建依赖。这些开销意味着一个只做几秒钟正事的 job,最终可能消耗整整几分钟的基础设施时间。我们为解决这个问题采取了以下几个步骤:
把共享依赖预装进 CI 镜像
我们的每个 API 测试分片每次运行都要花 7 到 8 秒用 apt 安装同一个 Postgres 客户端。我们把它移进一个包含 Node 和该客户端的小型 CI 基础镜像,让每个分片都能从一个「开箱即跑」的环境启动。后来我们发现 setup 期间下载原生构建头文件偶尔会挂起,于是把所需的头文件也加进了镜像,缩短了长尾。
每个 job 只安装它需要的依赖
Linear 的代码库是一个以 pnpm workspace 管理的 monorepo。我们的 API 测试工作流过去会安装整个 workspace,尽管它只需要 API 包及其依赖。把安装范围限制到 API 包后,pnpm install 从 44–73 秒降到 16–18 秒。我们把同样的模式应用到了 API 相邻的 job 上——它们此前都在安装完整仓库,并上传一个后续运行几乎从不命中的依赖缓存。
重建更快时就别缓存
我们还测试了缓存 node_modules,发现重建反而更快。缓存 key 依赖频繁变动的 lockfile,而且即使缓存命中,恢复也要大约 28 秒,而一次过滤安装只要约 7.5 秒。这个缓存增加了保存时间和不确定性,却没有带给我们任何可感知的好处。
这三项改动合计把每个分片的 setup 时间降低了大约 44%,从 110–140 秒降到 67–73 秒。
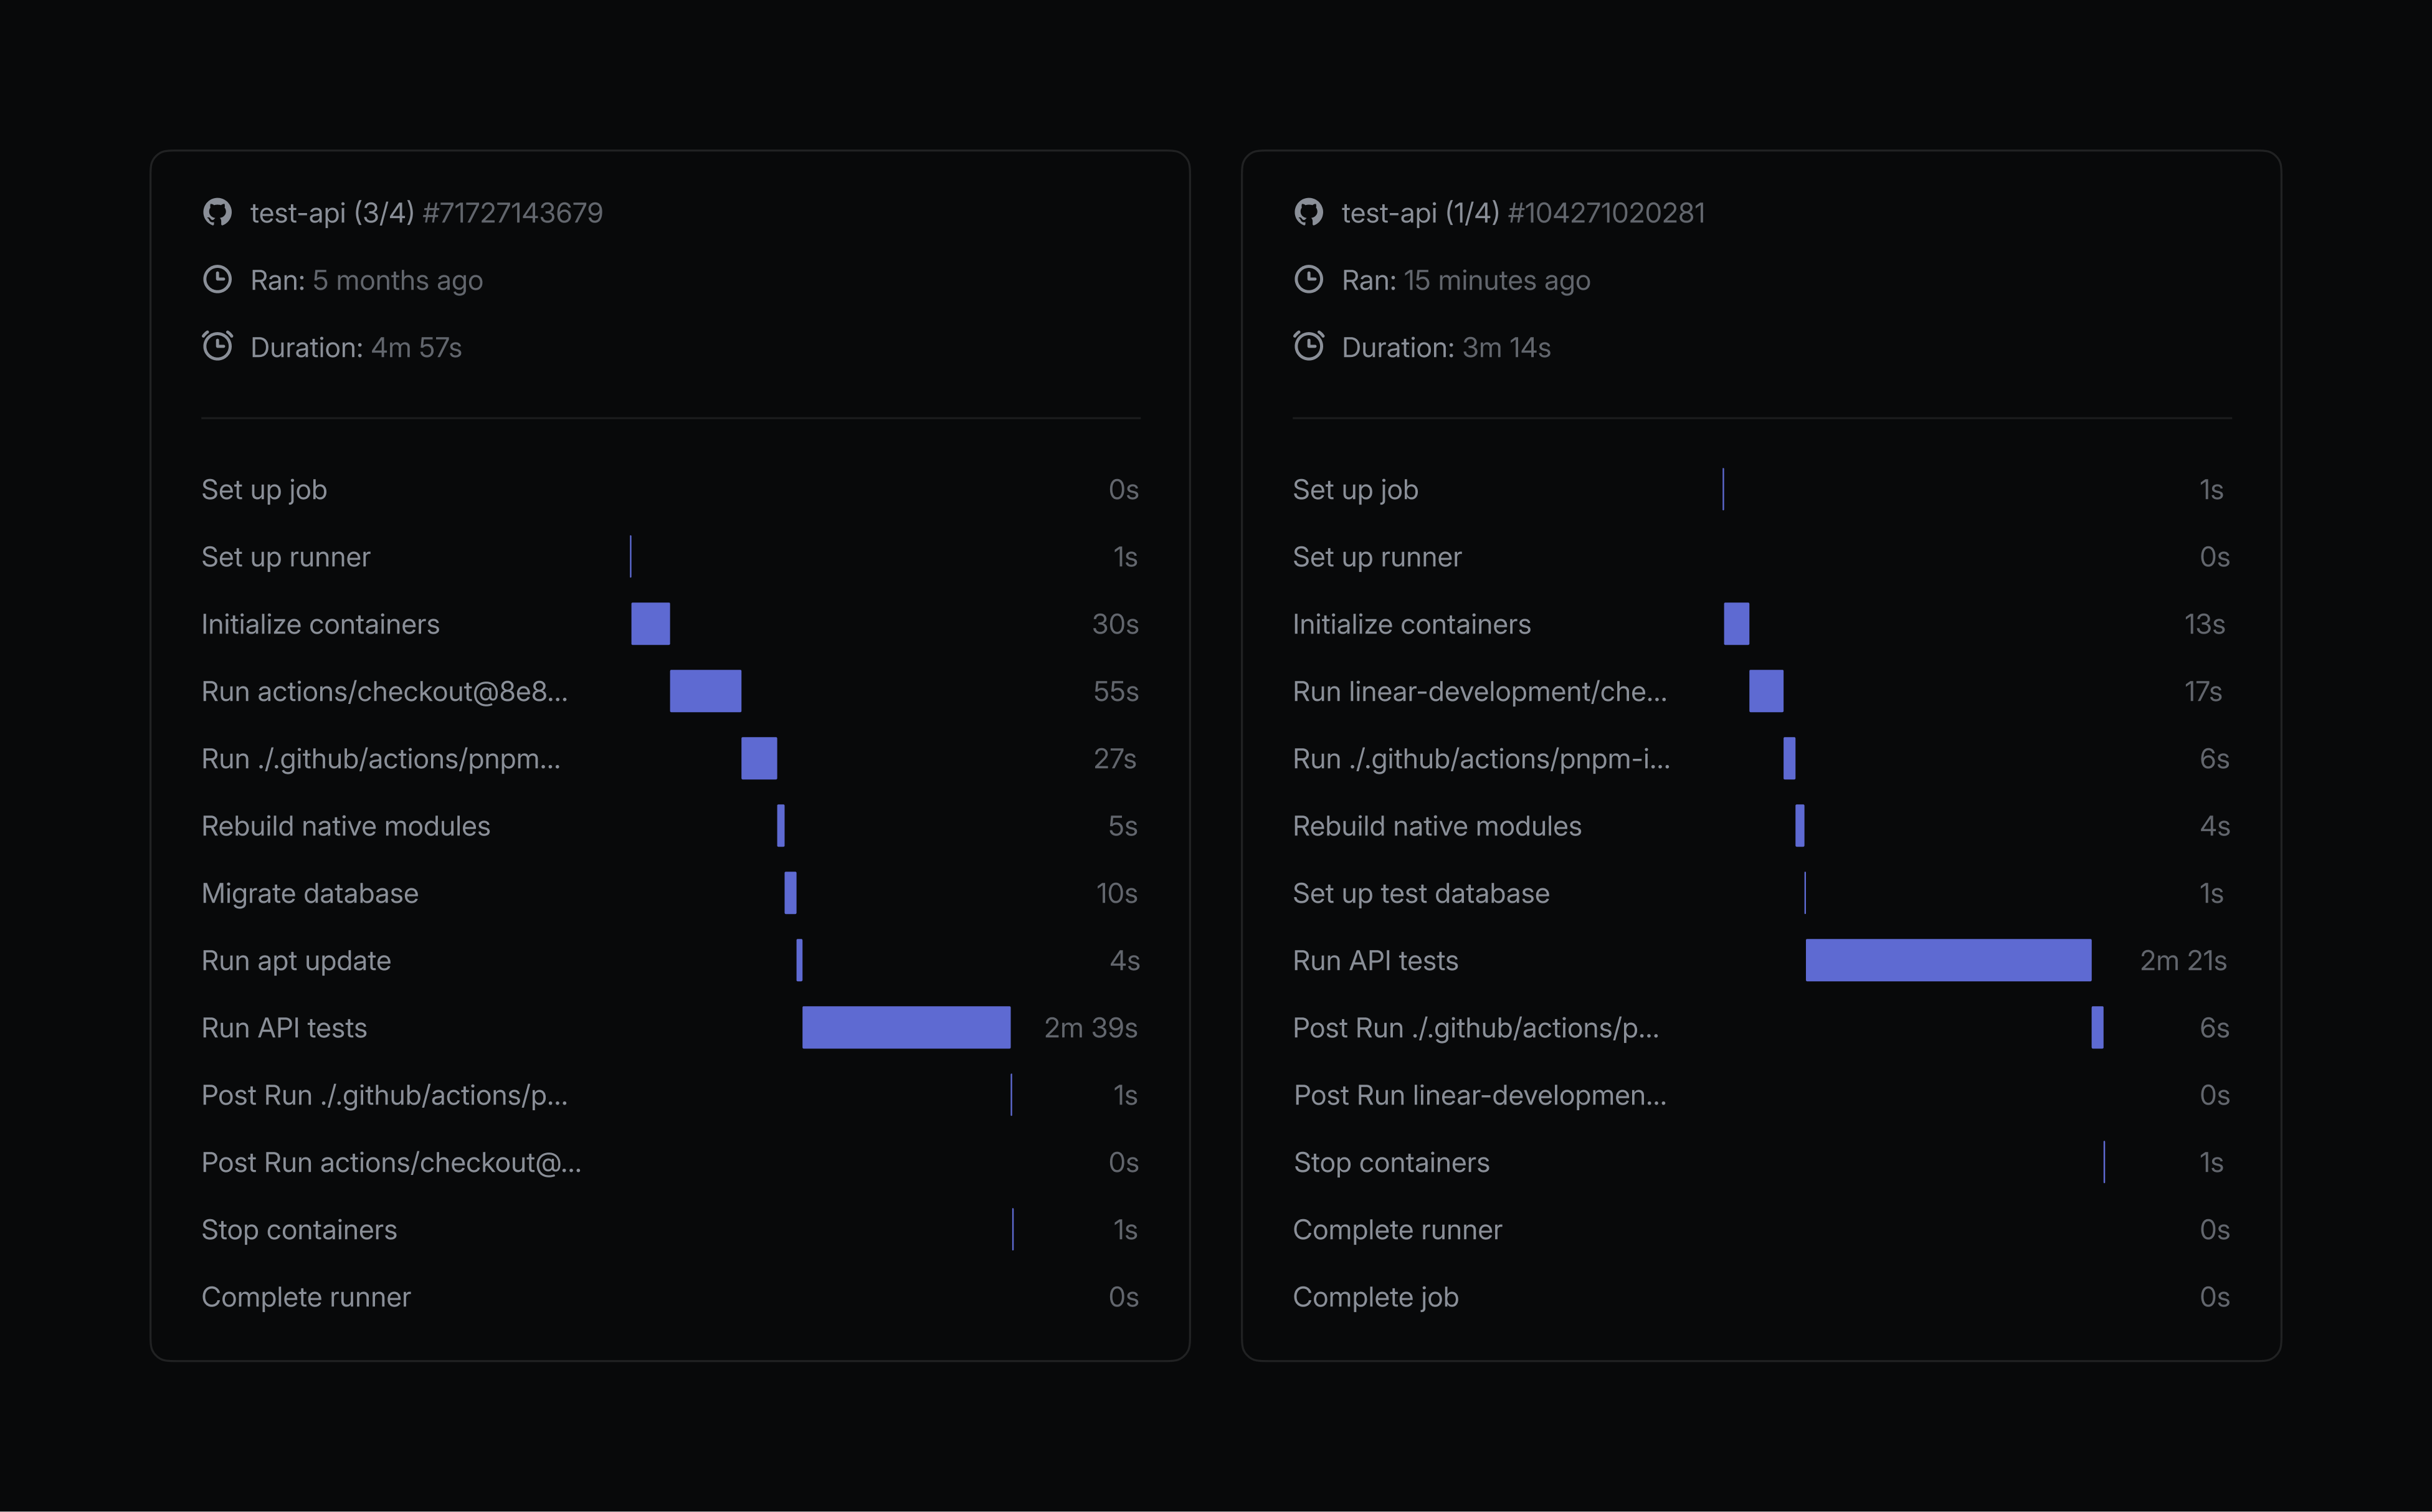
一个测试分片的 p95 时长
除此之外,还有一些其他形式的重复 setup 可以整个避开。
不要重放没有变化的 setup
有些 setup 工作只有在输入变化时才需要重做。比如我们的 API 容器过去每次运行都重放完整的数据库迁移历史,哪怕 PR 根本没改 schema。对这些场景,我们改为加载一份生成的 schema 快照和 bootstrap 文件,把每个容器的数据库 setup 从约 12 秒降到 1–2 秒。
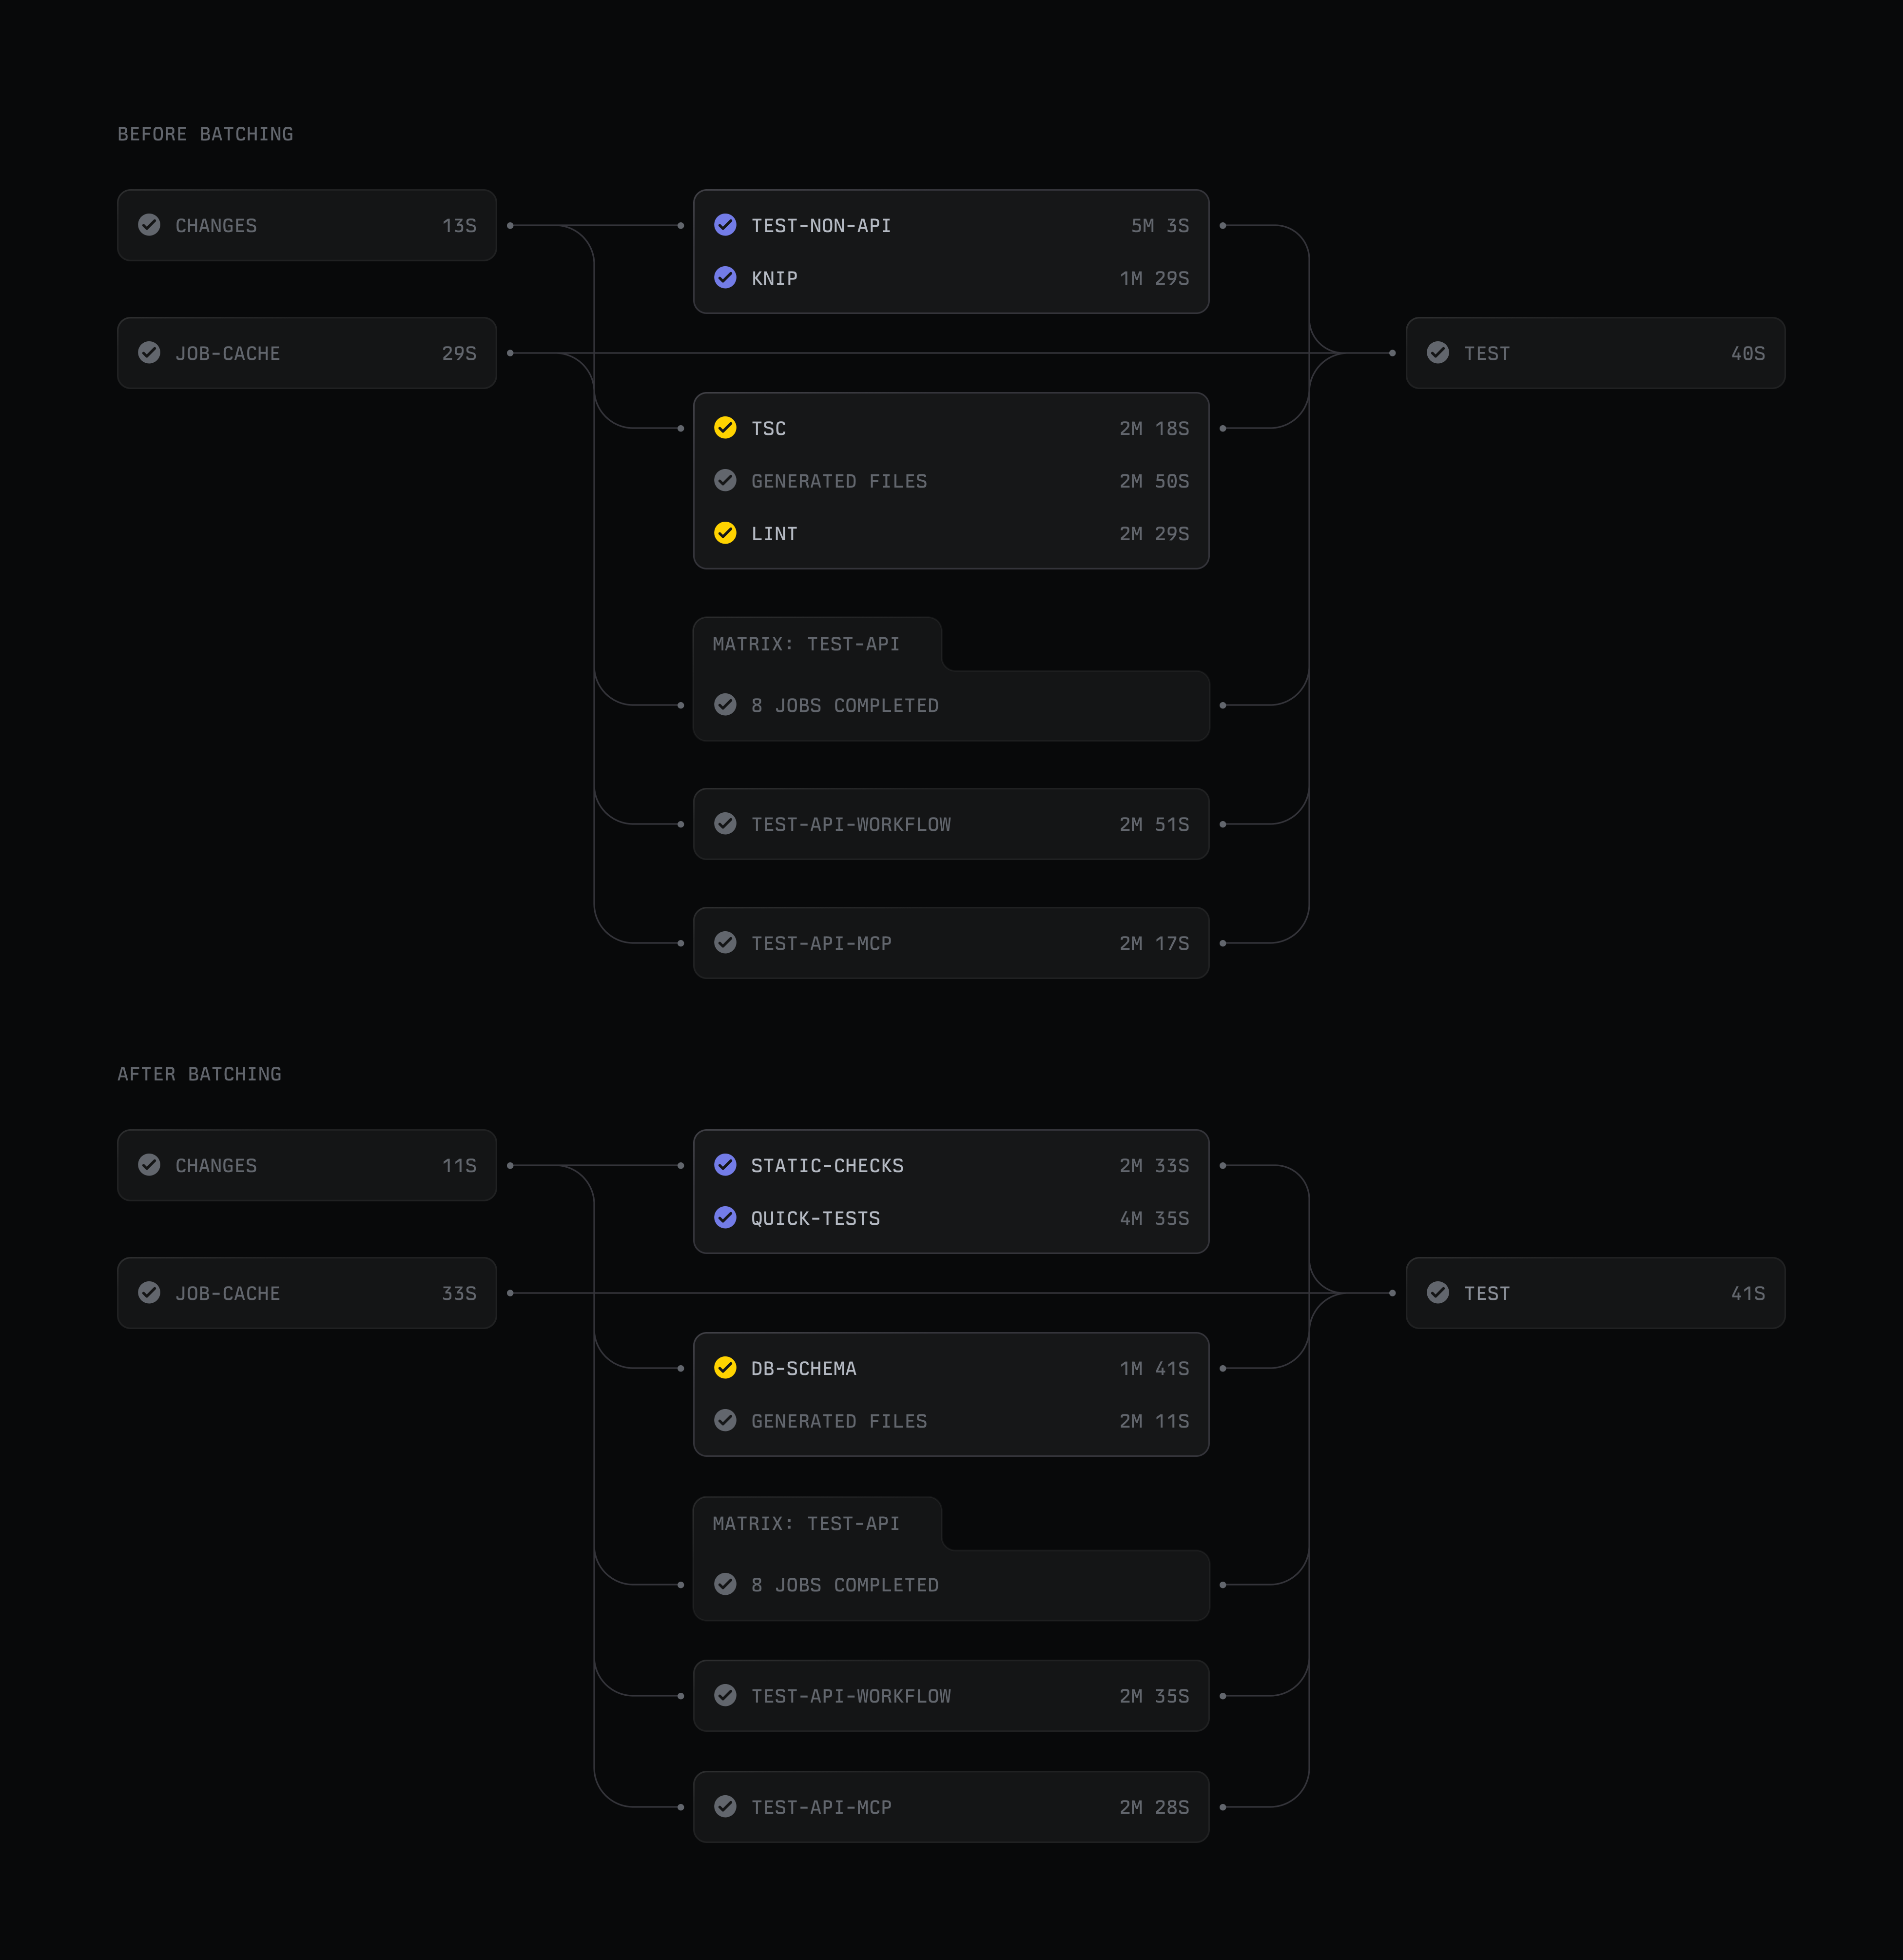
把短检查合并进更少的 job
七个相互独立的检查,每一个都要先启动 runner、checkout 仓库、安装依赖,然后只做几秒钟的正事。我们把它们合并成两个 job,再把这七个任务在其中并发运行。同一笔 setup 开销的支付次数从七次降到了两次。按 6 月的用量计算,这项改动每月节省约 87,000 runner 分钟,相当于我们 CI 总用量的 11.8%。
让测试执行更高效
随着每个测试分片的固定成本降下来,我们有余力把 API 套件并行得更激进。它是我们工作流中规模最大、执行最频繁的部分之一,所以这上面的改进对合并时间有超额的杠杆效应。
按测试运行器的视角平衡工作
Vitest——我们 TypeScript 测试套件用的测试运行器——按文件而不是按单个测试的时长分配工作。这意味着几个异常大的测试文件可能主导一个分片,实际拖住整套测试的完成时间,哪怕其他分片早就跑完了。
我们在保留测试结构的前提下,把这些大文件拆成更小、更聚焦的文件,然后评估了不同的分片与 runner 配置。今年早些时候我们已经从 3 个分片加到 4 个;这次加到 8 个后,在初始基准中关键 job 快了约 19%、便宜了 19%。改动一周后,最慢的分片从 5.25 分钟降到 4.33 分钟。
只在严格的隔离规则下共享模块状态
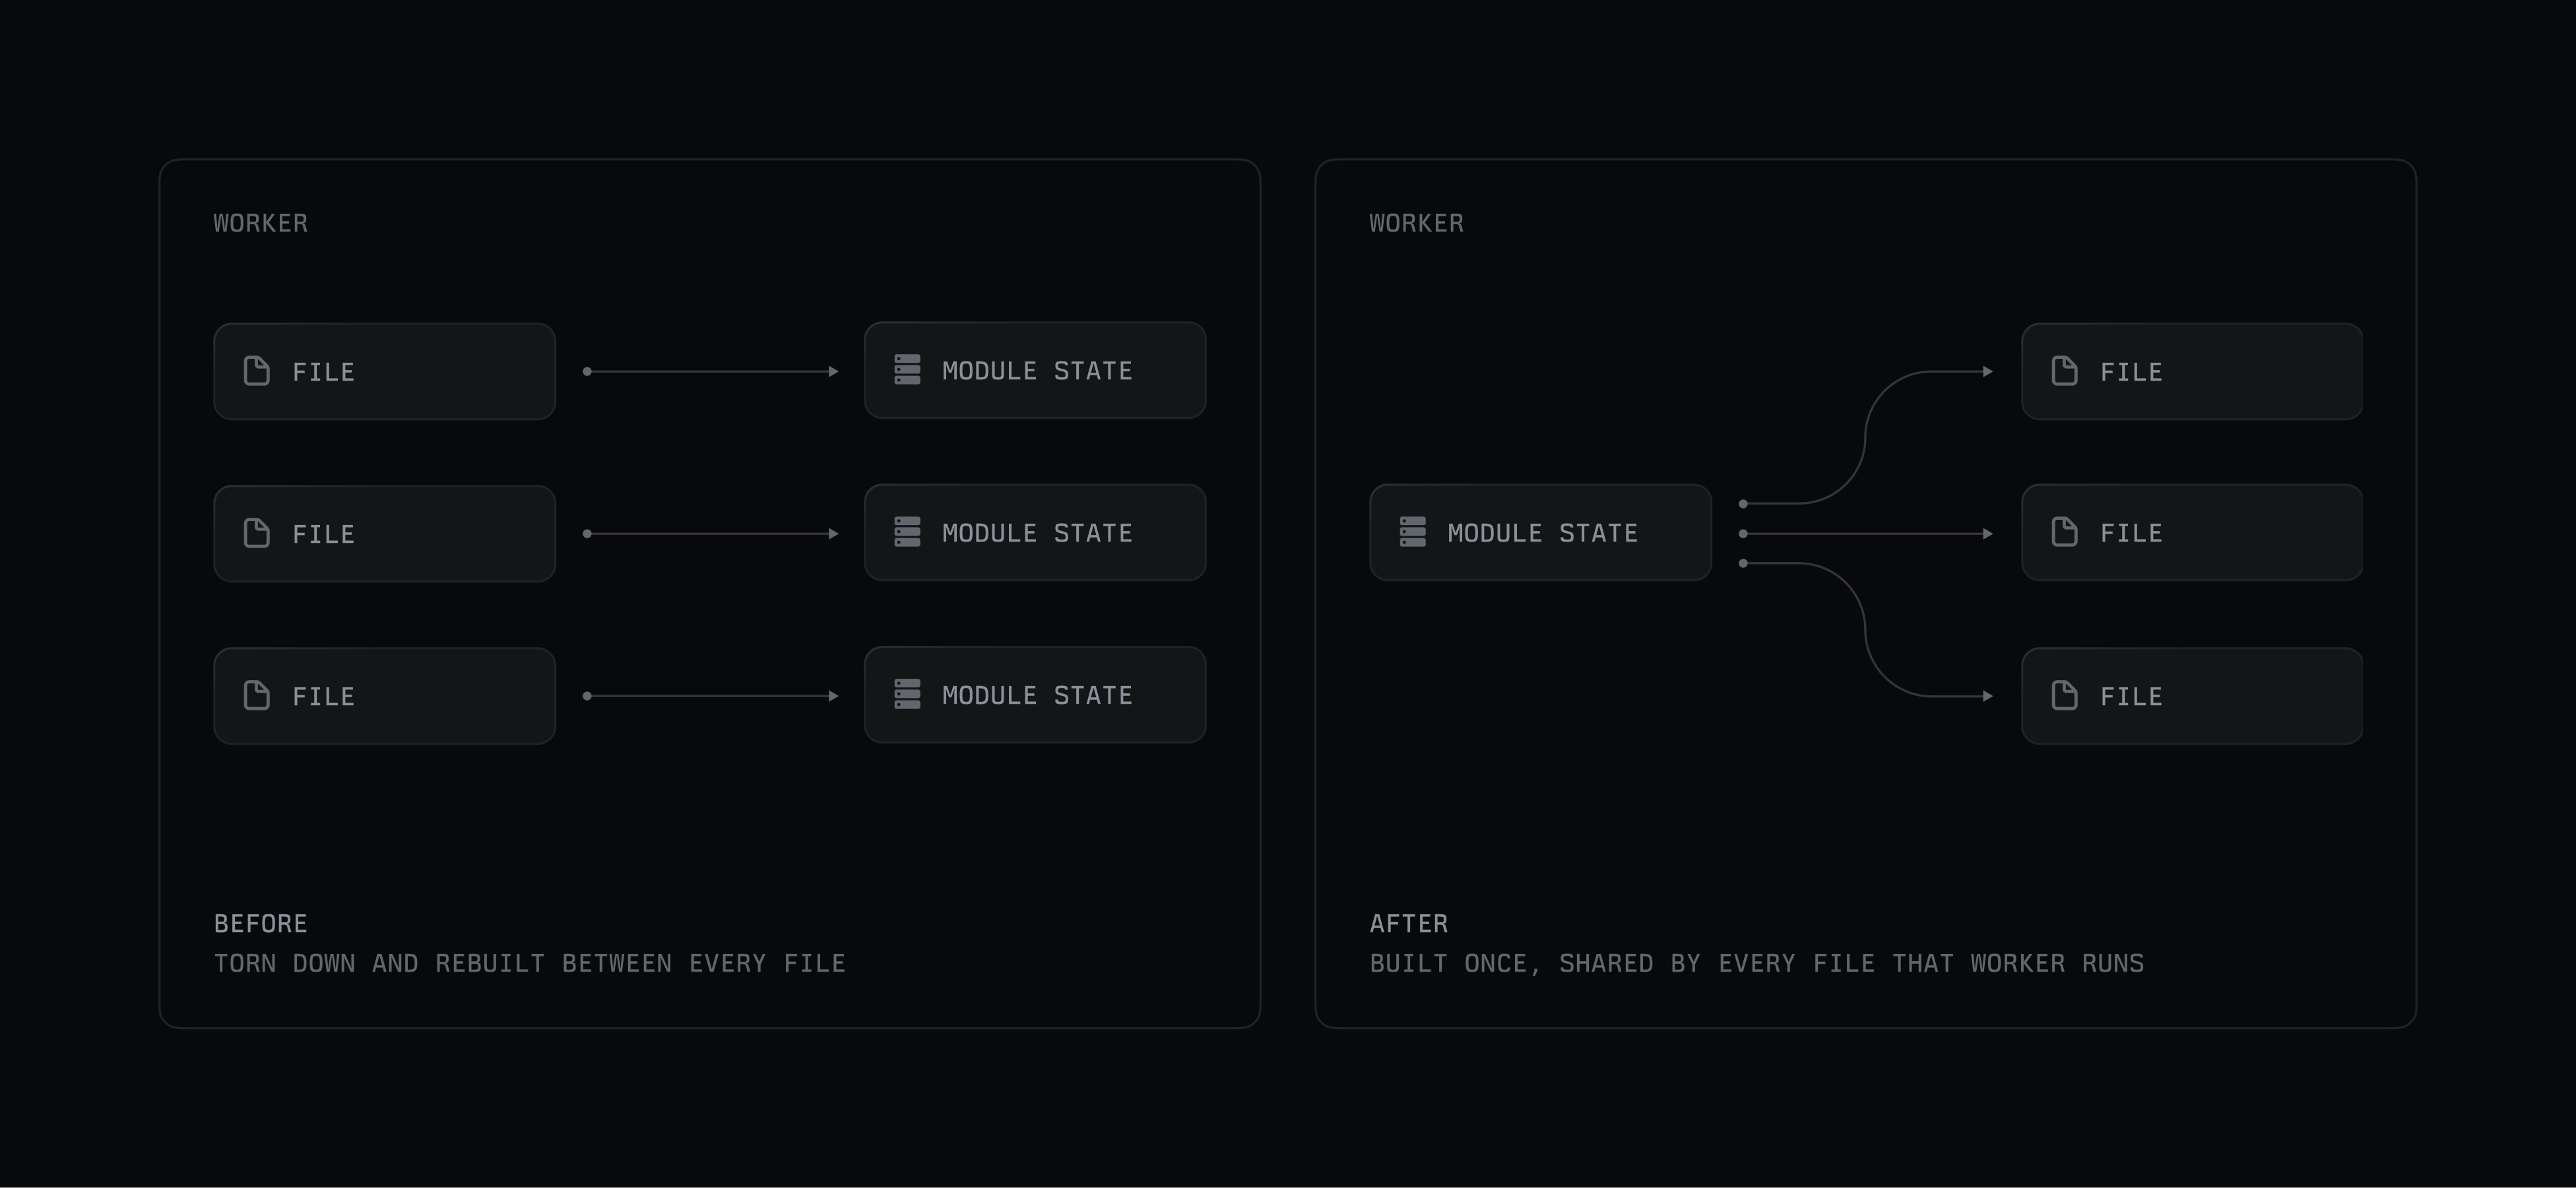
Vitest 默认隔离每个测试文件,对我们来说,这等于在每个测试分片里重建 entity、GraphQL 和装饰器图。我们引入了一个显式加入(opt-in)的 vitest project,配置 isolate: false,允许安全的文件在每个 worker 内共享同一个模块注册表。
这是我们单项最大的性能改进,在我们的量级下约值月度节省的 17%。最慢的分片从约 300–379 秒降到约 195 秒,API 分片每次运行的总 runner 时间从约 32.8 分钟降到 22 分钟。
它也是正确性风险最高的一项优化。我们用每个文件上的一条显式 opt-in 注释来明确资格,并为共享状态补上必要的 teardown。有少数文件以我们无法安全解绑的方式使用 fake timer 或共享状态,我们把它们留在了隔离的 project 里。而且,由于现在大部分测试由 agent 编写,我们也更新了各自的 agent skills 以纳入这个性能 opt-in,让生成的测试默认遵循同样的约束。
分片受限于 setup 开销
只有当每个分片的固定成本足够低时,继续加分片才划算,因为分片数翻倍,花在 setup 上的工作流时间也翻倍。前面提到的那些 setup 优化,正是让 8 个分片变得可行的原因。如果每个分片还要 110–140 秒,8 个分片光 setup 就要花 15–19 分钟 runner 时间,比测试本身还多。现在 setup 大约 40 秒,8 个分片的总 setup 时间反而比之前 4 个分片还少,同时把测试的并行度翻了一倍。
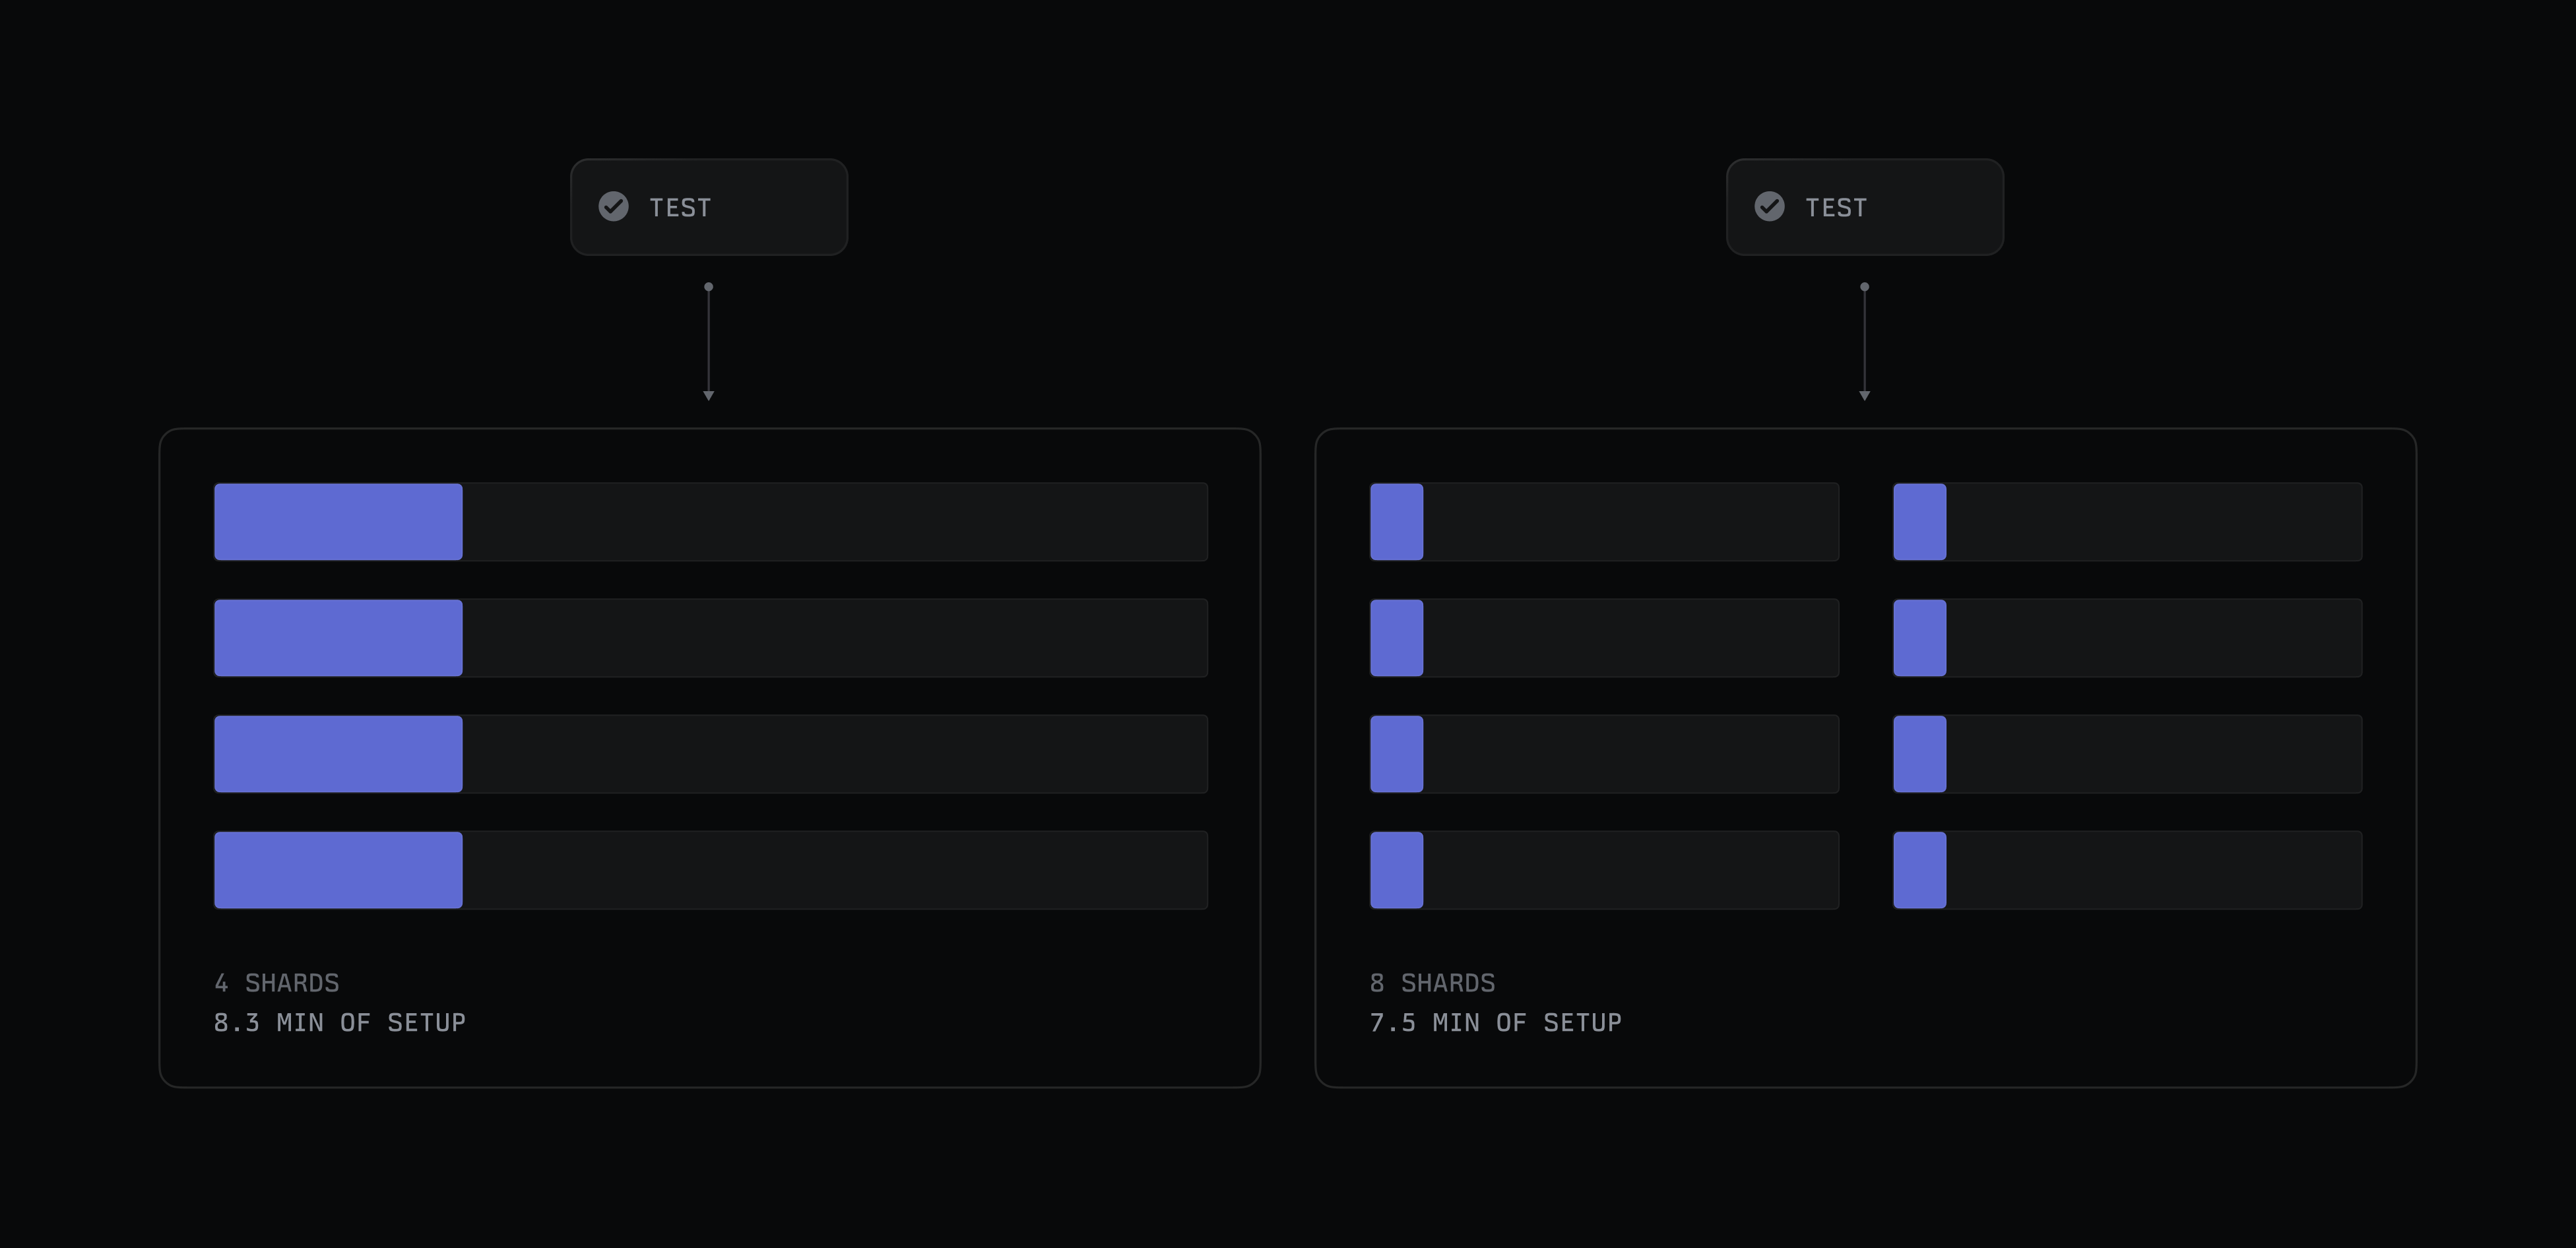
在 setup 优化之前,测试 job 用 4 个分片、setup 花了 8.3 分钟。优化之后,我们能用 7.5 分钟的 setup 跑 8 个分片。
在系统中层层放大的改进
如果今年早些时候没有专门下功夫改进 CI,今天的测试套件大约要跑 11 分钟,接近开发者现在等待时间的两倍。而且这项工作不会就此结束。显然我们的代码库还会继续增长;目前我们每周新增大约 2,000 个测试。在这样的增长下让 CI 保持快速,将是一项持续的工作——其中大部分,是把这个过程中的经验应用到新的瓶颈上。