每日文摘
深挖 · AI 时代的 CI/CD 改造:当 AI 每周写 2000 个测试,你的 CI 扛得住吗
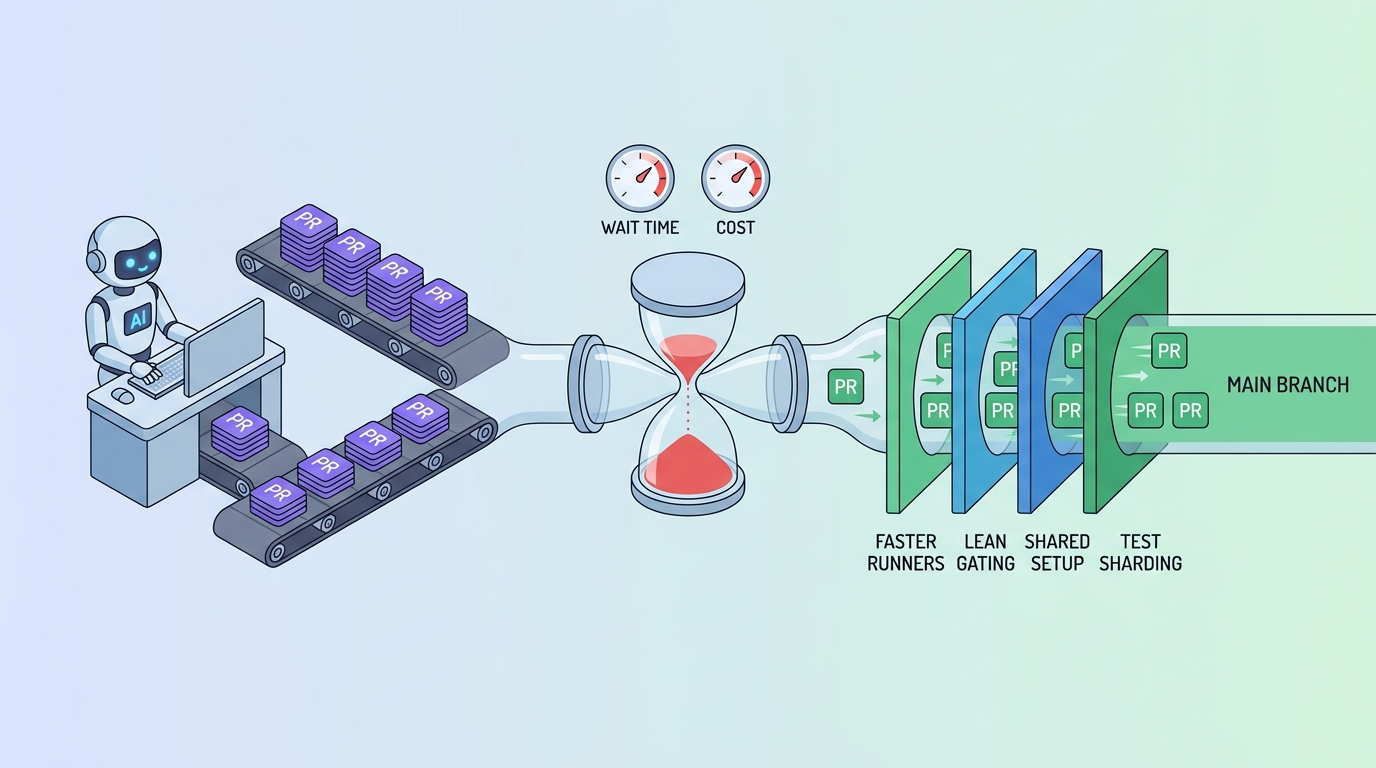
Linear 昨天发了一篇很「工程师味」的复盘:AI coding has made CI a bottleneck, so we reworked ours to keep up。数字很有意思——自年初以来他们的测试套件几乎翻了 4 倍,目前每周新增约 2,000 个测试,但 PR 等待时间反而从 6 分多钟降到了 5 分钟出头,每个测试消耗的 runner 时间大约减半(原文,已出中文翻译版)。这篇深挖把它放进全行业语境里看:AI 时代的 CI 瓶颈到底有多真实、除了 Linear 还有哪些成熟手段、对内部原有 CI/CD 流程的改造推荐什么路线。
瓶颈是真的:AI 把压力灌进了 CI
先确认这不是 Linear 一家的凡尔赛。Anthropic 自己的工程博客(2026-09-14)给出了目前最硬的一手数据:CI job 量 6 个月涨 25 倍,测试数量同期涨 10 倍,而工程师只增加了「名义上的一点点」;工程师季度交付代码量是 2021–2025 基线的 8 倍,其中 80% 由 Claude 编写。Anthropic 还观察到两个对容量规划致命的行为特征:agent 偏好更小、更细粒度的 PR(直接推高每日 CI job 数),且夜间周末持续工作(CI 活动基线不能再按人类上班时间建模)。他们自己的 test impact analysis 服务被这波流量压垮,三次扩容补丁全部失败,最后整体重写才活下来。
平台侧数据同向:GitHub 2025 年 commit 推送 9.86 亿次(+25%),Actions 公共项目消耗分钟数 115 亿(+35%)(Octoverse 2025)。GitClear 对 2.11 亿变更行的分析显示重度 AI 用户代码产出是非用户的 4–10 倍(报告)。
但有个反直觉的发现值得先摆出来:CI 压力来自「量」,不是「质」。Mergify 用 15.3 万次合并的平台数据做了统计——AI 辅助 PR 弄坏 main 分支的概率只有人工 PR 的一半(1.9% vs 4.4%),而且 AI 的 PR 反而更大(State of Merge Queues 2026)。所以这不是「AI 代码烂把 CI 搞挂」的故事,而是「提交频率爆炸 × 每 PR 门禁成本」的乘积爆炸。
对 agent 工作流来说,慢 CI 的代价也更尖:等 CI 的 agent 要么空转要么盲猜,一份成熟度模型的说法是「15 分钟的 CI 反馈回路对 agent 是架构问题」,建议把 fast-path(单测+lint+类型检查)压到 2 分钟内、全量 5 分钟内(VirtusLab,厂商口径)。Mitchell Hashimoto 的判断更狠:merge queue 是按人类节奏设计的串行车道,代码产出涨 10 倍是保守情形,届时队列先 buckle——「这不是 AI review 问题,是 release 问题」(Mergify 转述)。极端案例是 Bun:Claude 完成大部分的 Rust 重写,单 PR 6,755 commits、超 100 万行、9 天落地——瓶颈已经从写代码变成了「怎么把它合进仓库」(复盘)。
Linear 的四层改造:把 CI 当系统而非单点
Linear 这篇最有价值的不是任何单项技术,而是顺序。他们把 CI 当系统分四层改,每层都有数字(以下均出自原文):
**第一层:换算力与工具链。**GitHub Actions 迁到第三方 runner(更快 CPU、高性能存储、更好的缓存),切换前后各两天同等对比,job 平均快 34%,tsc 类负载快 52%;类型检查换原生编译器 tsgo,tsc 检查周中位数降 73%,瓶颈直接从类型检查上移走;把依赖类型信息的自定义 lint 规则重写为纯 AST 静态分析,ESLint 彻底甩掉 TypeScript——API lint 快 68%、全仓 lint 快 55%,还顺势迁到了 Oxlint。
**第二层:砍关键路径。**门控 job(变更检测这类「其他 job 都等它」的小 job)是放大器:fetch depth 按需限制后最慢门控从 94 秒降到 20 秒;不需要工作树的 job 干脆去掉 checkout(27→7 秒);push/merge-queue 用 sparse + blobless + 限历史的 checkout 再省 11 秒——变更检测 job 中位数 26→8 秒。另外把缓存标记写入从合并前最终检查移到不阻塞任何事的 job,每个 API PR 的合并路径省 42 秒。第三方 runner 在 GitHub 网络外、直连 IP 链路会间歇劣化,他们用自建 composite action 替换 actions/checkout:带回退重试、低速超时(GIT_HTTP_LOW_SPEED_LIMIT/GIT_HTTP_LOW_SPEED_TIME,30 秒中止停滞连接)、sticky 磁盘上的持久 git 镜像。
**第三层:消灭重复 setup。**共享依赖(Postgres 客户端)预装进 CI 基础镜像;pnpm monorepo 里每个 job 只装自己需要的包(pnpm install 从 44–73 秒降到 16–18 秒);实测发现 node_modules 缓存恢复(28 秒)比过滤安装(7.5 秒)还慢、且 key 依赖频繁变动的 lockfile,直接弃用——三项合计每分片 setup 降 44%(110–140→67–73 秒)。数据库容器不再重放完整迁移史,改加载生成的 schema 快照 + bootstrap 文件(每容器 ~12→1–2 秒);7 个「启动 runner 比干活还久」的短检查合并成 2 个 job 内并发,每月省约 87,000 runner 分钟,占 CI 总量 11.8%。
第四层:才是动测试本身。Vitest 按文件分活,大文件拖死整个分片——拆大文件后分片 3→4→8,关键 job 首测快 19%。单项最大优化是显式 opt-in 的 isolate: false project:安全的测试文件共享模块注册表,不再每个文件重建 entity/GraphQL/装饰器图——约占月度节省 17%,最慢分片从 300–379 秒降到约 195 秒。但这也是正确性风险最高的改动:每个文件要显式 opt-in 注释、共享状态必须 teardown、解不开的文件留在隔离 project。最 AI 时代的一笔是:因为现在大部分测试由 agent 编写,Linear 把这些约束写进了 agent skills,让 AI 生成的测试默认遵守。
还有一条贯穿的顺序论:分片数受限于 setup 开销。分片翻倍、setup 总时间也翻倍——如果 setup 还是 110–140 秒,8 个分片光 setup 就要 15–19 分钟;压到 40 秒后,8 分片的总 setup 反而低于优化前的 4 分片。不做这一切,Linear 今天的测试套件要跑约 11 分钟,接近现在的两倍。
业界工具箱:三条腿组合拳
把 Linear 之外的手段收拢,AI 时代的 CI 改造可以归纳成三条正交的腿——单价降、总量减、吞吐保:
单价降(每个检查更便宜):Rust 系工具链换代是「改一两行 CI 配置」级的收益——oxlint 官方口径比 ESLint 快 50–100 倍,tsgo 多数构建快约 10 倍(VS Code 77.8s→7.5s),Biome 比 Prettier 快约 35 倍,Python 侧 Ruff 快 10–100 倍(各官方文档)。缓存侧要知道 GitHub Actions 的机制约束:10 GB/仓库、7 天驱逐,且 PR 触发的缓存 scoped 到 merge ref、不能被其他 PR 复用——这是大仓库缓存命中率低的根源,Docker 大缓存官方推荐转 registry exporter(GitHub 文档、Docker 文档)。
总量减(少跑不必要的东西):monorepo 用 Nx affected / Turborepo --affected 只跑受影响项目并叠 remote cache(Nx、Turborepo);测试选择有两条路线——TIA 覆盖驱动(如 Datadog:Bloom filter 匹配、设计上只多跑不漏跑)和 PTS 预测式(ML 按失败概率选跑)。PTS 的源头锚点是 Meta:只跑受影响测试的约 1/3,仍捕获 >99.9% 的回归,测试基础设施成本减半(Meta 工程博客)。代价是要接受「少量回归漏到下一道防线」的风险模型。
吞吐保(合入不堵车):merge queue 把「各自绿、合并红」的修复成本前置成排队(GitHub 原生文档,工作流记得加 merge_group 触发,并发可调 1–100)。但别神化它:Mergify 自家实验显示动态批大小能吸收 agent PR 突发(高峰日 74% 的 check 配对执行),日均合并吞吐并没有提升(事故复盘)。
落地路线:算力从哪来
对内部团队,「改算力」有三档,价格全是 2026-01-01 GitHub 调价后的现行价:
- 官方内:GitHub hosted runner 今年降价最高 39%(标准 2 vCPU Linux $0.006/min,larger 8 vCPU $0.022/min);Linux arm64 对公共仓库免费(定价)。
- 第三方:Namespace $0 入门、8 vCPU $0.008/min(NVMe 持久缓存 + SSH 调试进运行中的 job);Ubicloud $0.00125/min 起(AGPL 开源,可整栈自托管);Blacksmith $0.004/min。8 vCPU 档约为官方 larger 的 1/3~2/3。
- 自托管:门槛比想象低得多——官方无硬件下限、只需出站 HTTPS 443、家庭宽带/NAT 可跑;原定 2026-03 起的 $0.002/min 自托管平台费已被官方推迟,当前 $0/分钟(2026 pricing changes,政策风险要盯)。对 unraid 用户还有个惊喜:unraid 官方 org 出了 ci-runner-farm 插件——每 slot 一个容器、CPU/内存限额(CI 饿不死 NAS 上的其他服务)、包缓存保温、BuildKit 自愈、watchdog 清残留,支持 GitHub Actions 和 GitLab CI。唯一红线写在 README 第一屏:只跑可信代码,别对公共仓库 fork PR 开放。
一个必须知道的市场信号:第三方 runner 的头部玩家 BuildJet 已于 2026-02-06 宣布关停(03-31 停服),官方理由直白——GitHub 自己追平了(“The gap we set out to fill has largely closed”,关停公告)。「换更快 runner」是正在关闭的窗口,不是长期方案;预算应优先投向测试选择、缓存和编排。
数据说话:哪些数字可信
这个领域的宣传水分不小,按可信度分三层:
- 一手硬数字:Meta PTS(1/3 测试量换 >99.9% 捕获,工程博客 + 论文)、Linear(全套内部对比)、Anthropic(25x/10x)。
- 厂商口径:Develocity/Launchable 宣传 PTS 省 50–70% 测试时间;而 Datadog、Shopify、GitHub、Uber 的官方一手帖均无量化数字,Shopify 广为流传的「每年挽回 27,000 工程小时」只找到 Graphite 二手转述。
- 第三方 runner 实测基本缺位:唯一持续更新的横评是 RunsOn 厂商自营(无利益冲突披露)——Namespace CPU 约 2.1 倍、缓存约 3.3 倍于 GitHub 官方(横评),远低于各家 headline 的 10x/40x。
风险面同样要如实记:AI 生成测试的质量有工业级数据——Meta TestGen-LLM 显示 LLM 生成测试 75% 能编译、57% 能稳定通过(论文),重过滤可用、裸采必炸,这正解释了 Linear 为什么要更新 agent skills 管住测试写法;isolate: false 这类「正确性换速度」的手段,Vitest 官方文档自带风险条款、GitHub 相关 issue 136 条(跨文件 mock 泄漏、fixture 永不重建都有实证),Linear 的 opt-in 注释 + teardown 是行业内较严格的驯服方式;连 merge queue 自己也会出事——GitHub 官方 merge queue 2026-04 出过约 4 小时 38 分的静默回滚事故(HN 讨论)。编排换吞吐,也有它的正确性账单。
值不值得跟:推荐改造清单
对「内部原有 CI/CD 怎么改」这个问题,调研支持的分步答案是:
- 度量先行:PR 等待时间、每测试 runner 分钟、CI 分钟/月——Linear 全文只优化这三个数,没有这三个基线一切优化无从验证。
- 零成本层(本周就能做):门禁工具换 Rust 系(oxlint/tsgo/Biome/Ruff,各改一两行配置);测试按历史耗时切分并行;缓存开满;PR 吞吐上来后开 merge queue。
- 中成本层:monorepo affected + remote cache;pnpm
--filter "...[origin/main]"部分安装部分测试;数据库用 schema 快照代替重放迁移史(Rails schema:load、Django –keepdb 有官方背书;Prisma 官方暂无捷径);短检查合并;共享依赖预装进 CI 镜像。 - 高收益高治理层:测试选择,先 TIA(只多跑不漏跑,安全)后 PTS(Meta 数字是锚点)——前提是团队接受「少量回归漏到下一道防线」。
- 算力层按序:公共仓库先吃 arm64 免费餐 → 爆发期流量分给 Namespace/Ubicloud → 常驻负载回自己的机器。
- AI 特有的一环:把 CI 约束写进 agent skills / AGENTS.md,让 AI 生成的测试和代码默认守规矩——Linear 已经证明这一步不是可选项;fast-path 门禁以 2 分钟为目标,agent 不空转。
对自家(202 unraid + 206 + 3090 机器)的具体建议:202 装 ci-runner-farm 做常驻 runner(吃缓存、跑常规 job),3090 机器用 LABELS 打标只接重型/GPU job;私有仓库爆发期用 Ubicloud burst($0.00125/min,还开源可自托管);顺手把 DailyNews 这类 repo 的 fast-path(lint+类型+单测切片)压进 2 分钟。
一句话收束:AI 时代 CI 改造的本质,是把「为人设计的验证流水线」改造成「为 agent 设计的验证服务」——快(2 分钟反馈)、省(选择 + 缓存 + 便宜算力)、稳(merge queue + 约束写进 agent 默认行为)。Linear 给了全套数字,Meta 给了测试选择的锚点,Anthropic 给了不做会发生什么。
参考阅读
- Linear: AI coding has made CI a bottleneck, so we reworked ours to keep up — 触发源,四层改造全套数字(中文翻译版)
- Anthropic: Agentic coding is straining CI — AI 时代 CI 压力最硬一手数据(25x/10x/80%)
- Meta: Predictive test selection — 测试选择路线源头(1/3 量换 >99.9%)
- Mergify: State of Merge Queues 2026 — AI PR 更少弄坏 main 的反直觉平台数据
- Mergify: Merge Queues Were Built for Humans. AI Agents Need More. — Hashimoto 论 agent 时代合并基建,含 Bun 1M 行案例
- BuildJet: We are shutting down — 第三方 runner 窗口关闭的直接证据
- GitHub: 2026 pricing changes for GitHub Actions — 2026 定价重做与自托管平台费推迟
- unraid/ci-runner-farm — unraid 官方 runner 农场插件