每日文摘
深挖 · Codebase-Memory-MCP:43.8k star 的代码知识图谱引擎,省 token 真但别信 99%
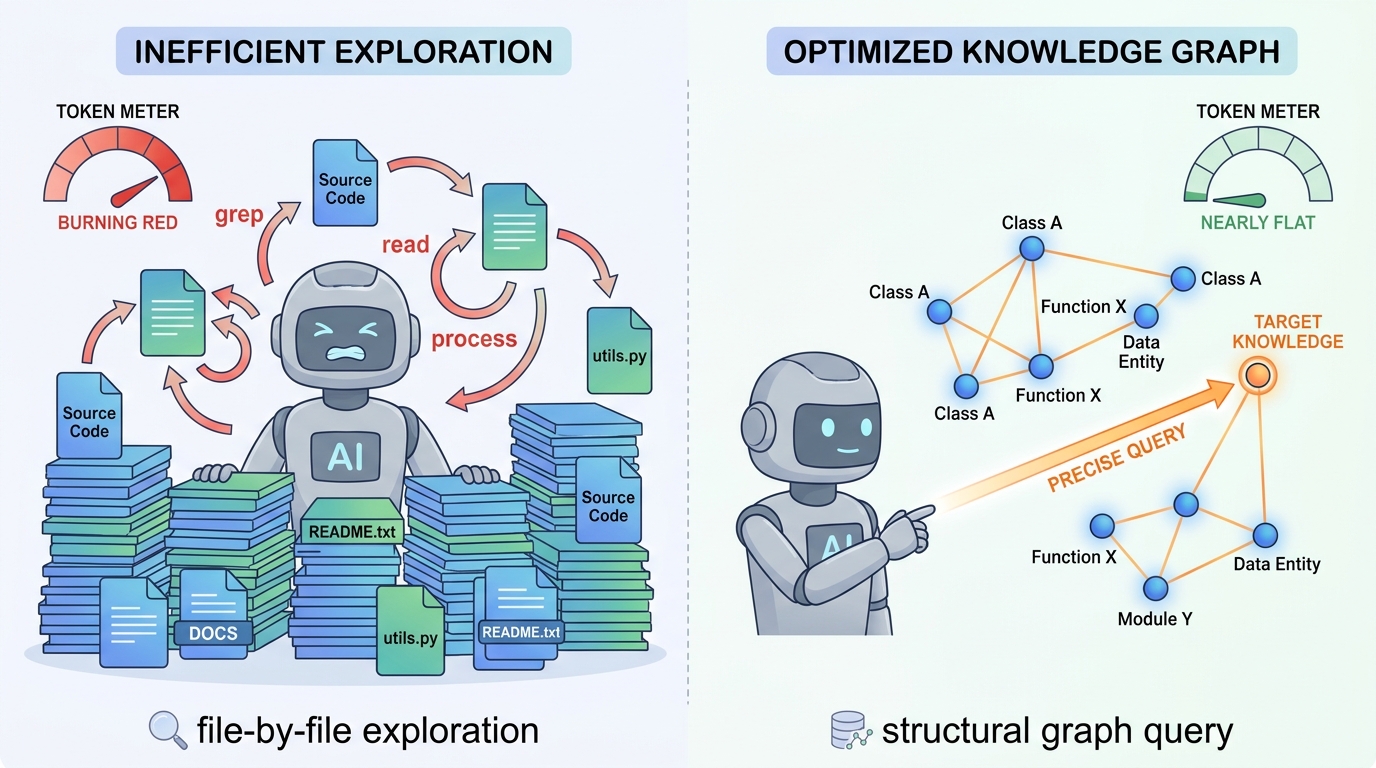
Codebase-Memory-MCP 是柏林个人开发者 Martin Vogel(GitHub ID:DeusData)今年 2 月底开源的 MCP server:用纯 C 写成单个二进制,把整个代码库索引成一张持久化知识图谱,让 coding agent 改「问图」而不是一轮轮 grep/read 翻文件。7 个月拿下 43.8k star(GitHub),README 上最响的口号是「120x fewer tokens / 99.2% 减少」——这句直击 vibe coding 钱包痛点的话,恰好也是这个项目最需要打折看待的地方:它自家论文的诚实数字是 10 倍,社区里还有三人独立复现「挂着它反而更费 token」。这篇深挖就回答三个问题:它是什么、怎么做到省 token 的、以及你该不该在下一个项目里挂上它。
是什么
先确认身份:仓库 DeusData/codebase-memory-mcp,MIT 协议,主语言 C,2026-02-24 建仓,7 个月 43,834 stars / 3,570 forks,调研当天仍在活跃提交;第一贡献人 DeusData 独占约 58% 的 commits,是个标准的单人主导项目(GitHub API、contributors)。作者账号其余仓库全是 ≤5 star 的杂项,这是他唯一有影响力的作品;社区还存在一个整合了 9 个未合并上游 PR 的分叉 win4r/codebase-memory-mcp-pro(230 stars,GitHub)。
它的定位在 README 里说得很直白:一个 structural analysis backend——本体不含任何 LLM,只负责建图和查图,「你正在对话的那个 agent 就是查询翻译器」(README)。卖点是三件套:全库索引快(Linux kernel 2800 万行 3 分钟)、结构查询亚毫秒、以及那句 99% fewer tokens。
一个细节先埋个伏笔:语言支持数在它自家材料里有三个口径——仓库描述写 158、README 徽章写 162、评测计划文档写 159,官方从未解释差异(GitHub API、EVALUATION_PLAN.md)。这个项目从营销数字到文档口径,都需要你带着核对的习惯去读。
核心机制(技术)
索引管线:把 158 个 tree-sitter 语法(vendored 编译进二进制)解析成 AST,再跑多趟管线——structure → definitions → calls → HTTP links → config → tests——最终产出一张知识图谱:13 类节点(File/Class/Function/Route/Resource 等)、20 种边(CALLS、IMPORTS、HTTP_CALLS、DATA_FLOWS 等),连 Dockerfile/K8s 清单这类 IaC 也建为图节点(README)。
光有 tree-sitter 不够——README 自己承认 tree-sitter 追踪不了 imports、泛型、继承和标准库类型。所以它在其上叠了一层自研的 Hybrid LSP 类型解析(C 实现,兼容 tsserver/pyright/gopls 的设计),把调用点精确解析成 CALLS 边,覆盖 Python、TS/JS、Go、Rust、Java、Kotlin 等十种语言(README)。这是它和一众「tree-sitter 套壳」项目的主要分界线。
查询面:15 个 MCP 工具。search_graph 是结构/BM25 全文/语义三合一检索(语义用编译进二进制的 nomic-embed-code int8 模型,无需 API key);trace_path 查调用链;query_graph 直接跑只读 openCypher 子集(MATCH (f:Function)-[:CALLS]->(g) WHERE f.name='main' RETURN g.name);detect_changes 把 git diff 映射到受影响符号并做风险分级;get_architecture 一发拿到全库语言/入口/路由/热点总览(README)。存储就是本地 SQLite(WAL 模式),索引期间 RAM-first、结束落盘释放(README)。
省 token 的三重机制,这是理解它全部争议的钥匙:
- 图查询替代逐文件读——agent 问「谁调用了 X」,拿到的是符号名+边的紧凑列表,而不是几十轮 grep/read 把整个文件内容拉进上下文(Discussion #12);
- 输出整形——MCP 响应用紧凑树渲染、前缀目录压缩、语义截断+游标翻页,控制工具输出本身占的 token(README);
- hooks 注入——安装时写入 PreToolUse hook,观察 agent 的 Grep/Glob/Bash 调用并把图符号作为附加上下文附上,README 称 fail-open 不拦截(README)。
工程质量出乎意料地高:7 个月 3,056 commits,自称 8,060 个测试,SLSA L3 构建溯源、cosign 签名、每个 release 过 VirusTotal、CodeQL 门禁,docs/ 下还有 35 语言逐题的 BENCHMARK.md(GitHub API、BENCHMARK.md)。一个人把发布工程做到这个程度,要么是热爱,要么是刷履历——但 bus factor 低是实打实的风险。
怎么跑起来(环境)
安装是这类工具里最省心的:macOS/Linux 一行 curl,或 npm/pip/Homebrew,或直接下 Releases 预编译包(darwin-arm64、linux-amd64 都有);无 Docker。依赖为零——不需要 LLM API key、不需要 Ollama、不需要外部向量库,嵌入模型编译在二进制里,100% 本地、无遥测(README)。
接入面号称 45 个客户端(39 个自动检测):Claude Code、Codex、Cursor、Windsurf、VS Code 全自动,装完对 agent 说一句 “Index this project” 就完了;pi 也在自动检测列表里;不在矩阵的客户端(比如 ZCode)走通用手动配置——任意 stdio MCP 客户端填一段 mcpServers JSON 把 command 指向二进制即可(README)。
成本方面没有 API 费,剩下的是机器开销:索引速度官方口径是 Django 约 6 秒、kernel 3 分钟(M3 Pro),之后由 git watcher 增量维护;稳态内存占用官方没公布(可用 CBM_DIAGNOSTICS=1 自测)。两个部署注意点:npm 安装的 postinstall 需要联网下载二进制,纯内网机器建议直接用 Releases 的 tar.gz,CBM_DOWNLOAD_URL 明确支持自托管分发;另外它的 install 不只写 MCP 配置,还会给客户端装 skills、hooks 和 custom agents——这层侵入性在受控环境里要先评估(README)。
数据说话(评测)
这是本次深挖的核心问题:vibe coding 时挂着它,token 到底省不省? 把所有数字摆在一起看,答案分三层。
第一层:宣传口径。 README 的「120x / 99.2%」来自 5 个结构化查询:约 3,400 tokens vs 逐文件探索的约 412,000 tokens(README)。维护者在 Discussion #12 给过逐题明细——按名找函数 225x、调用链追踪 150x、死代码检测 170x、列路由 155x、架构总览 67x(Discussion #12)。注意这 5 个题目全是对图最有利的纯结构化问题,token 只计「答题阶段」,全部作者自跑,原始数据不发布(作者自己声明复现需要原始输入)。
第二层:论文口径。 作者团队的预印本(arXiv:2603.27277,未经同行评审)在 31 个真实仓库上测出的完整数字是:answer quality 83%、token 少 10 倍、tool calls 少 2.1 倍。但摘要里同一段还写着基线(用 grep/Glob/Read 的文件探索 agent)的答案质量是 92%——比图方案高 9 个百分点。README 引用时只摘了 83%/10x/2.1x,把基线更高这半句留下了(arXiv)。更妙的是,项目自己的评测计划文档承认 full-session token ratio(整个会话含摸索成本)才是 “the headline honesty metric”,且对比条件不对称——Graph 侧拿了工具使用提示,基线侧没有(EVALUATION_PLAN.md);自带的测量方法学文档更是明文警告 “Never turn a result from one repository, question set, model, or machine into a universal savings claim”(MEASURING_SAVINGS.md)。营销页和方法学文档,一个在加油门,一个在踩刹车。
第三层:社区实测,正反都有。 正面:r/mcp 用户用 Claude Code 的 /context 在一个小 Flask 项目上自测,架构总览类问题省约 40% token、快约 2 倍,结论是 “Big repo, big win. Small repo, meh.";另有用户实测同一任务 52 秒完成,不挂 MCP 要 5 分半——速度是所有实测里最无争议的收益(r/mcp)。反面:issue #1129 里三名用户各自独立复现挂着它 token 反而多耗 40%–72%(同一任务 74K vs 43K input tokens;Claude Code 上对话消息 103k vs 48k),楼主最终弃用,owner 承认输出臃肿但明说修复「不能证明这些报告已解决」,issue 至今未关(issue #1129);#1356 有人测出一次 index_status 调用就吐出约 26k tokens(issue #1356);hooks 的副作用也有账:#188 hook 把 Read/Grep 全拦了、只能手删,#214 hook 一会话多次触发逼得 Claude 想办法绕路,#69 则证明不加 CLAUDE.md 指令 Claude 根本不会主动用它(#188、#69)。
独立第三方的严格 benchmark:没找到——搜到的「评测」文章数字全部转述 README/论文,部分还是 AI 生成站。另一个值得记录的异常:43.8k stars 的项目,HN 自投帖最高只有 4 分(HN),watchers 仅 176;没有刷 star 的实证,但传播生态里大量无独立测量的复述文,让这个星数该打几折见仁见智。
同类比较:这条赛道正处于爆发期,而且比它星数高的不止一个——Graphify 119.7k(Claude skill、用 vision 概率性抽取建图)、claude-mem 94.3k(会话记忆)、mem0 65.7k(通用记忆层)、本尊 43.8k、code-review-graph 31.6k(机制高度相似、聚焦 review)、serena 29.6k(LSP 实时符号检索+可写编辑)、repomix 28.4k(把仓库打包成单文件,方向正好相反)、claude-context 12.5k(向量语义检索)。它的差异化不在机制独创——预建代码图这条路早有人走——而在确定性索引(对比 Graphify 的概率抽取)、图查询能力(对比向量近似检索)和执行质量(kernel 3 分钟、查询亚毫秒);它不做的也清楚:不改代码(serena 的域)、不记对话(claude-mem/mem0 的域),与 Claude Code 的 /compact 一个事前减量一个事后压缩,互补不替代(各项目 star 数均来自 GitHub API 2026-09-20 实测,serena、repomix、claude-context)。
值不值得跟
把三层证据叠起来,「vibe coding 省 token」这个问题的诚实答案是:机制成立,幅度看场景,99% 别信。
- 该用的场景:大型代码库 + 结构化导航问题——谁调用 X、调用链、改动影响面、死代码、架构总览。这里有作者 10x 论文数字和第三方 40% 实测双重支撑,且速度收益(分钟级变秒级)是零争议的。典型如反复回访的开源项目学习、接手陌生大仓库。
- 慎用的场景:中小仓库、以写码为主的日常 vibe coding。#1129 三人复现的负收益(多耗 40–72%)就发生在这类场景,根因是工具输出和对话消息膨胀;且答案准确率有 9 个百分点的真实折损——省下的钱买不回改错的代码。
- 采用姿势:别把它当「99% 省 token 工具」,当「大代码库的结构化导航加速器」。挂上后第一件事是用
/context在自己的 repo 上做一次 A/B——这是第三方实测者和项目自家方法学文档罕见达成一致的建议。零依赖、无遥测、纯本地,试错成本只是一次索引的等待时间;hook 的侵入性(装完检查一下它往你的客户端配置里写了什么)是唯一需要留神的。 - 跟踪信号:#1129 是否随 compact output 真正关闭、arXiv 论文是否过同行评审、单人 bus factor 是否缓解——这三件事任何一个变了,结论都值得重估。
一句话收尾:这是个工程执行质量远超同类、方法学文档比营销口号诚实的项目——只可惜 README 首屏选择只讲对它最有利的那组数字。工具本身值得进工具箱,宣传语请自动除以十。
参考阅读
- README(DeusData/codebase-memory-mcp) — 卖点、架构、45 客户端矩阵、性能表的一手来源
- arXiv:2603.27277 — 作者团队评测论文,83% vs 92% 质量折损的原始出处
- MEASURING_SAVINGS.md — 项目自带的 token 测量方法学与「勿外推」警告
- issue #1129 — 「反而更费 token」三人独立复现,owner 承认未证修复
- Discussion #12 — 120x 数字的逐题明细与方法论
- r/mcp 实测帖 — 第三方 /context 实测:~40% 节省与 “99% is marketing” 的结论