每日文摘
深挖 · Better Harness:阿里 Qoder 开源的 harness 体检平台,评的不是模型,是你给 agent 搭的工程系统
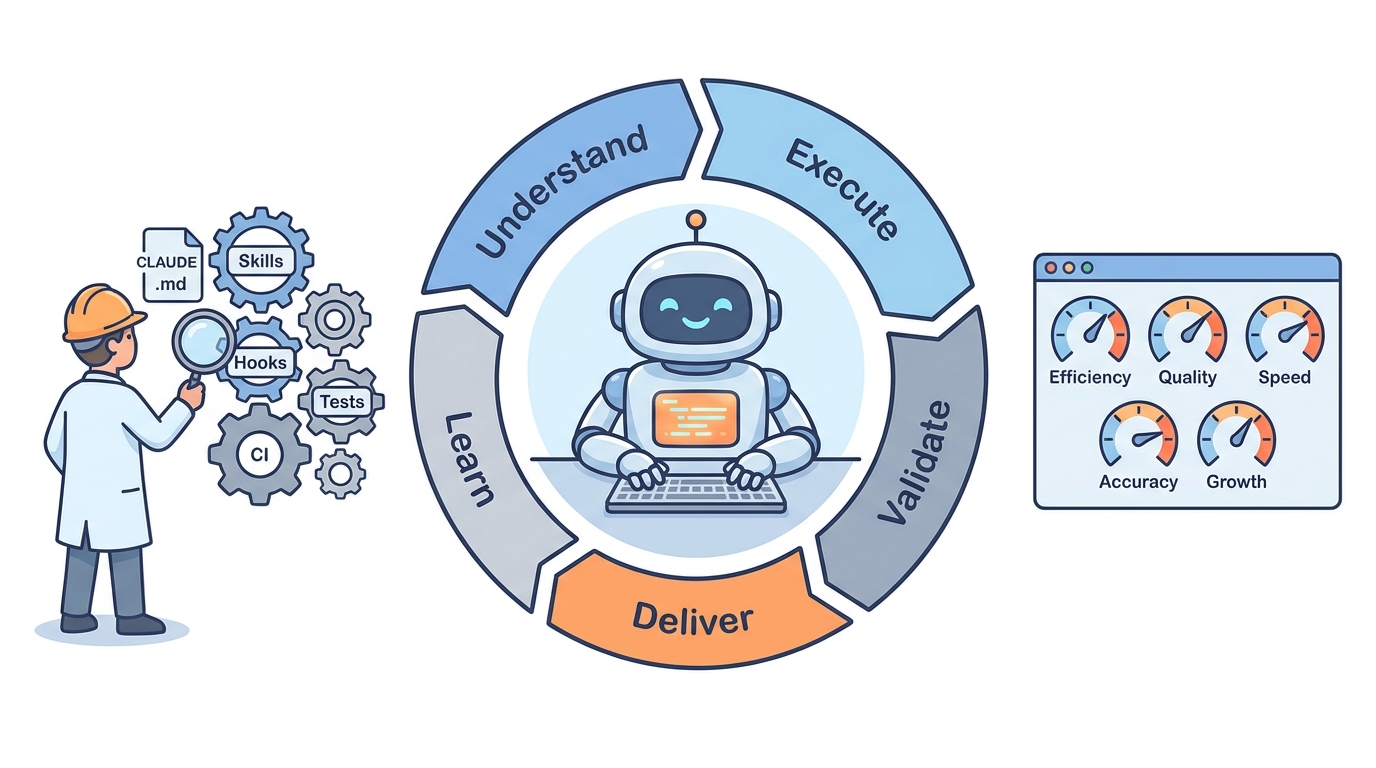
这两天中文科技媒体的口径是「阿里云 Qoder 开源了一个 Better harness」。打开 仓库 看,它既不是 Qwen Code 那样的 CLI,也不是又一个 Claude Code 平替,而是一个给 coding agent 做「工程系统体检」的开源平台:自己不写一行代码,专门评估你围绕 agent 搭的那套系统——规则文件、skills、hooks、测试、交付流程——到底有没有用。2026-07-21 建仓,MIT,目前 2304 star,主力作者 phodal(黄峰达)一个人贡献了 83% 的 commits。这篇把它是什么、怎么跑、证据成色如何、值不值得跟,一次讲清。
是什么
官方自述一句话:“Delegate coding to agents. Improve the loop around them."——把编码交给 agent,去改进 agent 周围的 loop。它把自己的工作对象叫 harness(agent 外壳):AGENTS.md/CLAUDE.md 这样的规则、skills、MCP 工具、hooks、测试、CI、review 流程,全部算 harness。
这个定位不是凭空发明的。Martin Fowler 网站 2026 年 4 月的 《Harness engineering for coding agent users》 提出了 “Agent = Model + Harness” 的拆法:模型能力你控制不了,但喂给它的前馈(specs、规则、skills)和反馈(tests、linters、hooks)是你能控制的工程系统。Better Harness 是这篇文章的可运行落地,README 直接引用了它。
它要治的病,官方列了五个,每个用 agent 的人都见过:目标模糊(agent 自信地解错题)、路径即兴(不可复现)、“It works” 但没有证据、速度绕过质量门、教训不沉淀。文档里还有一句很锋利的话:只 review 最终 diff,会漏掉这些系统层的问题。更锋利的是它对「checklist 思维」的否定——配置清单只能证明项目「有什么」(has),证明不了 agent 真的用了(did)、结果真的支持交付。has 与 did 之间的鸿沟,就是这个项目存在的理由。
顺带纠正一个传播偏差:「阿里云 Qoder 开源」是 国内媒体口径。仓库在 QoderAI org 下,Qoder 是阿里系的 agentic coding 平台(其桌面版内置了这个功能),但 README 没有自证阿里归属——这个细节不影响使用,影响的是你对它「官方背景」的预期。
核心机制
评估对象叫 Agent Work Loop,五个维度,每个维度 3 个子检查,共 15 项:
- Task Understanding——agent 知道目标和「做完」的定义吗(由 Rules/AGENTS.md/specs 支撑)
- Controlled Execution——工作在可复现的路径上吗(由 Skills/MCP/沙箱支撑)
- Change Validation——改动真的 work 有证据吗(由 tests/lint/Hooks 支撑)
- Reliable Delivery——AI 速度绕过 review 和验收了吗(由审批/CI/回滚支撑)
- Learning Capture——下一个任务受益于这一个吗(由 Loop Discovery/Memory 支撑)
打分机制是整个项目最有意思的设计。它不给「配置了就有分」:每项检查要落到七种证据状态之一——机制存在(Present)、可达(Wired)、被用过并留痕(Exercised)、后续结果支持效果(Outcome-supported)、缺失、未观测、不适用。前四个维度按最高证据状态封顶:Missing 59、Present 74、Wired 84、Exercised 94、Outcome-supported 100;第五维由评审 agent 给 35–100 的整数。模型文档里有一句反直觉的原则原文:“A configured capability is not observed use."——配置了不等于用了。这正是它和一切「检查你有没有 CLAUDE.md」式 lint 工具的分野。
执行管线是确定性代码和 LLM 的严格分工:
- Step 1:确定性 Node CLI(约 30 个子命令)采三条互相独立的证据 lane——Session Evidence(宿主会话转录)、Project Harness(git/测试/CI 等静态证据)、Agent Customize(AGENTS.md/Skills/MCP/Hooks 等资产的清点与完整性检查)。
- Step 2:spawn 恰好 3 个只读子代理并行分析,各只拿本 lane 数据,各出 3–5 个候选 finding——注意,子代理没有打分权。
- Step 3:Lead(就是宿主里正在跑的那个 agent 自己)做裁决:验证因果链,定 severity 和五维分数,过质量门。
- Step 4:回到 CLI 渲染 report.html + report.md + findings.json,机器校验不过不算数。
两个设计值得单独划线。其一,它没有自己的模型层——判断用宿主的模型(Claude Code 里跑就用 Claude),仓库零 provider/API key 配置,运行时依赖只有 yaml、esbuild-wasm、tree-sitter-wasm 三个本地库。其二,只出修复计划不自动执行:“Better Harness does not execute them."——每条 finding 带证据、预期结果、修复边界、验证路径,改不改你自己决定,官方态度是 “A report is the start of a loop, not a verdict”(报告是循环的起点,不是判决)。
工程体量在同类新项目里算重的:源码约 18.1 万行,测试约 9.5 万行,497 个 markdown 文档,ADR、specs、模型 rationale 一应俱全——rationale 文档 逐维引用 OpenAI 的 Harness Engineering 博文、Google SWE Book、SRE Postmortem Culture 来推导模型形状,同时声明这些文献「不是打分的证据源」。反面是治理集中度:590 个 commits 里 phodal 占 492,正式 release 只有 2 个(v0.4.1 和 v0.7.0-alpha2),还在 0.x 快速迭代期。
怎么跑起来
分发形态是宿主插件,不是 pip/binary。各宿主的安装命令(摘自 官方 Installation 文档 和 Adapter Matrix):
- Claude Code:
/plugin marketplace add QoderAI/better-harness→/plugin install better-harness@better-harness。支持状态 verified(quickstart 级)。 - dsh:
dsh plugin --profile <name> add @qoder-ai/better-harness。developer-preview 切片,没有插件生命周期,官方只对 dsh-v0.1.0-rc.7/rc.8 验证过。 - pi:
pi install(adapter 级,卡在完整的 report-loop smoke 测试,未进 Quickstart)。 - Qwen Code:
qwen extensions install QoderAI/better-harness。 - Cursor:无已验证安装路径。Qoder 桌面版内置。
用法:在目标仓库先用宿主跑一个真实的 session/task,然后执行 /better-harness analyze this project's AI coding workflow and generate an evidence-backed report。没有会话也能跑——node scripts/better-harness.mjs report --no-sessions 是纯静态检查,零 LLM 成本,代价是产物不含会话维度的发现。纯插件用户不需要 Node;只有 standalone CLI 或源码构建需要 Node ≥22.20。
成本和隐私对个人用户友好:工具免费(MIT);一次完整评估 = 宿主的一次 lead 会话 + 3 个并行只读子代理,token 计入宿主自己的账单(官方没有给单次评估的 token 数字,社区实测也还没检索到);quick 模式回看 7 天会话,normal 是 30 天。数据流纯本地——无服务端组件,报告落在本地,preview 服务只听 127.0.0.1,用户目录、Memory 正文、原始 session 都要显式授权才读,文档层面没有任何上传云端的行为。想接本地模型(比如 vLLM + Qwen)也不在 BH 层配置——它没有模型层,在宿主层(如 Qwen Code)设 base_url 即可,BH 会照常跑——这是机制推断,官方没有正式背书。
数据说话
先说结论:官方在效果证据上克制到近乎反常。README 和文档站没有任何「用了之后 token 降 x%、成功率升 x%」的数字;交互演示明确标注用的是虚构数据(fictional English data);history 视图自我声明 “shows recorded trends, not causal proof of improvement”。「30 个真实项目 × 4 个模型族 × 120 份报告」的模型校准、「开源三天 10 万人试用」,都是官方自述,没有第三方验证。这与国内媒体的报道声量形成明显反差。
最硬的质疑在 issue #95:用户直接追问 59/74/84/94/100 的评分上限是怎么校准的。phodal 的回复值得原样引用——这些值是 “normative anti-inflation ceilings, not empirically calibrated thresholds”(规范性的防通胀护栏,不是经验校准的阈值);62 分和 72 分的区别"没有可复现的 rubric”;裸分数不应跨 provider、跨项目、跨报告版本、跨评审者比较。评分主观性不是被社区抓到的把柄,是维护者亲口确认的已知边界。
社区反响有一个耐人寻味的错位。英文社区这边,OpenAI 的 Harness Engineering 博文在 HN 拿了 297 分,Lilian Weng 的《Harness engineering for self-improvement》拿了 334 分,humanlayer 的批评文《Why Software Factories Fail》拿了 394 分——品类热度是真的;HarnessTax 讨论 里用户明确在喊「我们需要更好的 harness benchmark,现在人人都在 trust me bro」。而 Better Harness 在 HN 和 Reddit 上是零讨论,传播全部发生在中文渠道。原因不难猜:它是「规范审查 + 证据链」路线,不是英文社区想要的那种「可跑分的 harness benchmark」——两者有本质差别。
使用痕迹是真实的:知名中文开发者 oldwinter 报过 UI bug,issue 区有一批具体到环境的技术问题;但核心链路也有仍 open 的 bug(#164:lead lane 在 Claude 上必现失败,2026-09-10 提出)。生态互动比值偏低——2304 star 对 39 个真实 issue、3 条 discussions(全部 0 回复)、5 个 watching;未找到任何刷量指控,也未找到任何第三方公司声明在生产使用。
值不值得跟
回到这次深挖的原始问题:它和 Claude Code、pi、dsh 是什么关系?不是竞品,是上下层。Claude Code(Anthropic 官方重度可配置终端 agent)、pi(badlogic 的极简可自我扩展工具箱)、dsh(DeepSeek 的 everything-is-a-plugin harness)是宿主;Better Harness 是装进宿主的评估器,读宿主的配置资产和会话转录,输出改进项。它和模型网关也是正交的——没有模型层,Claude Code 走 ANTHROPIC_BASE_URL、dsh/pi 走各自的自定义 provider,网关该怎么路由还怎么路由,四个东西可以同时共存。
对「ZCode + Claude Code + dsh + pi + CCR 网关」这样的多 CLI 环境,结论分层:Claude Code 侧可以直接试(verified 支持,装完对既有项目跑一次 report,看看自己的 CLAUDE.md/skills/hooks 被评出什么);dsh 侧观望——BH 对 dsh 是 developer-preview,dsh 自己又声明会有破坏性变更,双向漂移风险都不低;pi 侧 adapter 级,等它进 Quickstart。ZCode 不在官方 12+1 宿主清单里,但这不构成障碍——在另外几个宿主里装就行,报告输出是 host-neutral 的自包含 HTML。
但比「装不装」更值钱的是三样可以直接拿走的东西:
- 五维 + 15 子检查 + 证据状态机,本身就是一个脱离工具可用的 agent 工程自检清单。把 Present/Wired/Exercised/Outcome-supported 这四档套在自己的工作流上问一遍(「我的 CLAUDE.md 是存在、可达,还是真的被用过并留下了痕迹?」),不需要跑任何工具就有收获;仓库
references/下的判断指南是可以整体迁移的资产。 - 「确定性收集 + LLM 裁决隔离」是多 agent 评估防漂移的一个落地样本:子代理互不见彼此结论、没有打分权,只出候选;分数由 Lead 独立裁决并过质量门;渲染回到 CLI 且机器校验必须过。任何要做「用 LLM 评估 LLM 工作流」的人(包括各种自动化 pipeline)都值得抄这个分工。
- 可 diff、可重跑的报告工程:findings.json 契约 + 机器校验渲染 + 「重跑看 signal 移动而非一次判决」的改进观,比任何单次分数都更接近可持续的工程实践。
风险画像也要说明白:两个月大的项目、单人主导、0.x 版本、核心链路有 open bug、零第三方生产采用——这个画像和之前深挖过的不少「明星新项目」一致,合理姿势是抄思想优先于装依赖。好在它最核心的资产(评估模型、判断指南、五维框架)恰恰全部开源且不依赖工具本身存活——这大概是这个仓库最「言行一致」的地方:一个讲 harness engineering 的项目,把自己最有价值的部分做成了可复制的外壳。
参考阅读
- QoderAI/better-harness 仓库 — 真源:README、skills/、models/ 全部在这
- models/agent-work-loop.md — 五维/15 checks/证据状态机/评分上限的原文
- Adapter Matrix — 12+1 宿主的支持状态与边界,判断能不能装看这个
- Issue #95:评分校准质疑 — 维护者亲口确认评分是规范性护栏非经验校准
- Harness engineering for coding agent users(martinfowler.com) — 概念母体,理解「评 harness 不评 diff」
- Better Harness docs — Introduction — 定位与五个失败模式的官方表述
- Open-source 官方博文 — 开源动机、三 lane 机制、校准自述
- IT之家报道 — 国内媒体口径样本,和官方文档对照着读