每日文摘
深挖 · breeze-tts:14.4GB 单卡可跑、商用受限的「无参考 voice design」少数派
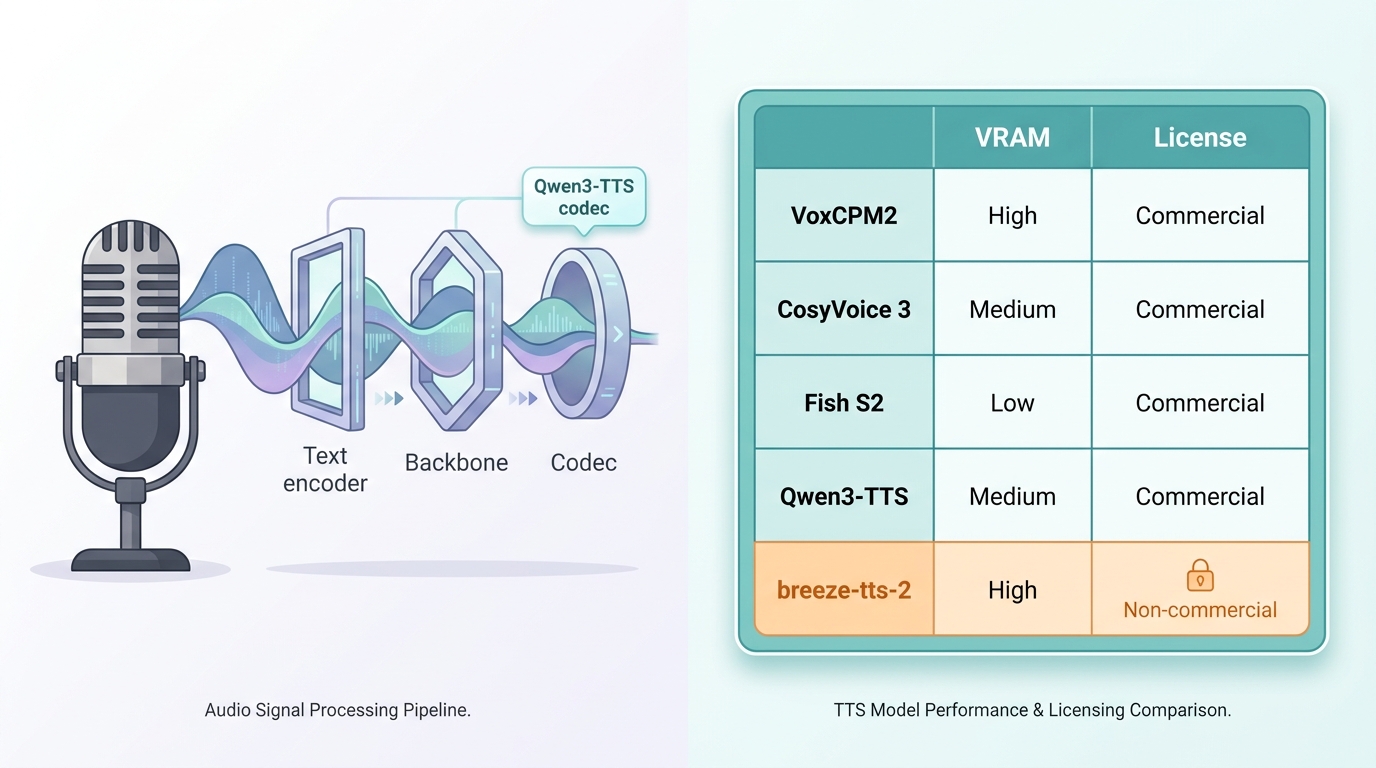
breeze-tts-2 是 breezeblue-ai 在 2026-08-25 发布的开源 PyTorch TTS,代码 Apache-2.0、权重走 Research Non-Commercial 路径。它在主流开源 TTS 里是个异类:别的项目都堆「voice clone 相似度」和「多语种」,它的差异化卖点是 voice design——不靠参考音频,纯用自然语言描述就能生成一个声音。这次深挖不打算给你看又一份「README 翻译」,而是想正面回答用户原始的四个问题:它到底能做什么、跟 VoxCPM2 / CosyVoice 3 / Fish S2 / Qwen3-TTS 比处在什么位置、什么场景适合用、资源占用到底是多少。
是什么
breezeblue-ai/breeze-tts 自称「Official PyTorch inference for Breeze TTS 2」,2026-08-25 发布 v2 权重 + 推理代码,2026-08-07 还发布过三项 TTS benchmark(voice design / voice direction / latency)。仓库体量很轻——13 commit、424 star、4 issue、1 PR,issue creation 还被设置成受限。
License 是这次深挖最重要的第一手事实:
- 代码:Apache 2.0
- 模型权重 / 自托管输出:「BreezeBlue Research and Non-Commercial License」——非商用
- 商用路径:必须订阅 breezeblue.ai 才能在平台 / API 生成可商用内容
这是典型的「代码开源 + 权重闭源商业化」套娃模式,跟 OpenAI / ElevenLabs 闭源路线类似,但开放度介于 VoxCPM2(Apache-2.0 全栈可商用)和 ElevenLabs(完全闭源)之间。
v1(breeze-tts)到 v2 的具体差异 README 没给——参数量、训练数据量、训练小时数、WER / CER / SIM / UTMOS 全部未公开;没有 arXiv 论文;HF 主页 401/404。
核心机制(技术)
breeze-tts-2 的能力谱分四档:
| 能力 | 触发条件 | 备注 |
|---|---|---|
| Voice Clone | 参考音频 + 精确文本 | 主流克隆路径 |
| Voice Design | 无参考音频 + 自然语言描述 | 差异化卖点 |
| Voice Direction | 参考音频 + 自然语言指令(tone / emotion / pace / delivery) | 风格微调 |
| Vocal Events | 文本内联标签——英文 (laugh)/(cough)/(coughs throat)/(sigh)、中文 [笑]/[咳嗽]/[清嗓子]/[叹气] | 非语音事件 |
仅支持 EN + ZH 双语。README 没提 voice conversion、long-form synthesis、跨语种克隆(除 EN/ZH 基础支持)、自定义情绪或口音。
架构分四个组件:Text encoder → Backbone(prefill + decode)→ Depth decoder → Codec。关键事实:它的音频 tokenizer 直接基于 Qwen3-TTS(Alibaba Qwen Team)——结构上 codec 与 Qwen3-TTS 同源,但 text encoder / backbone / depth decoder 是 breezeblue-ai 自有。输出 24 kHz mono signed 16-bit little-endian PCM。
完整架构细节(是不是 LM + diffusion、是否 Flow matching、decoder 阶段数)README 没有——这是和 VoxCPM2 / CosyVoice 3 那种「论文级技术报告」开源 TTS 最大的透明度差距。
怎么跑起来(环境)
部署路径有三条,全部是原生 PyTorch:
# 1. CLI
git clone https://github.com/breezeblue-ai/breeze-tts.git
cd breeze-tts
python -m pip install -r requirements.txt
python infer.py ...

# 2. Streaming API(默认端口 7860,路径 /v1/audio/speech,multipart form)
python -m breeze_infer.api ../breeze-tts-2 --host 0.0.0.0 --port 7860

# 3. Docker(默认 H100/Hopper sm90;A100 需加 FLASH_ATTN_CUDA_ARCHS=80)
bash docker/build.sh
官方只支持 Linux + CUDA-capable NVIDIA GPU——无 vLLM、TensorRT-LLM、SGLang 官方路径,无 Apple Silicon / CPU 支持。Python ≥ 3.10。
资源占用
| 路径 | 显存 | 速度 | 来源 |
|---|---|---|---|
| 官方 PyTorch eager | ≈ 7.7 GiB | 单并发 | README |
| 官方 PyTorch –fast-all | ≈ 14.4 GiB | H100 RTF 0.32(≈ 3.1× 实时) | README |
| 第三方 audio.cpp(llama.cpp 派生) | 6 GiB | 4× 实时,无 Python | issue #3 by 0xShug0 |
| ComfyUI 集成 | — | — | issue #1 by Saganaki22 |
关键对比:audio.cpp 6GB 比 PyTorch –fast-all 14.4GB 还要省——比 206 已在跑的 VoxCPM2 vLLM-Omni 13GB 还要省一半。这意味着如果你愿意走 llama.cpp 家族路线,单张 3060/4060 都能跑。
API 形态是 POST /v1/audio/speech,字段 cfg_scale / ref_audio / ref_text / text / instruction / seed——路径名与 OpenAI 同名,但 multipart form 协议不兼容,不能直接换 OpenAI 客户端。流式仅 PCM 一种形式,没有 SSE / WebSocket 分层。默认单并发;--fast-all 启用 fast path 但没暴露 max_concurrency 调参——并发数字官方完全没给,社区有 issue #15 在问,仍 open。
与你机器的适配
- 206(vLLM-Omni 跑 VoxCPM2 13GB):能跑 breeze-tts-2(显存够),但要走原生 PyTorch 路径,重起服务、不能复用现有 vLLM 体系
- 3090(24GB):完整跑 –fast-all 14.4GB 充裕;audio.cpp 6GB 路径极低资源,比 VoxCPM2 还省
- Mac M 系列:不可行——无 MPS 路径
数据说话(评测)
这是这次深挖最关键的负面发现。
官方数字
- TTFA < 40ms / RTF 0.32(H100 warmed-up fast path,官方数字)
- 声明「ranks #1 among open-weight models on the Artificial Analysis TTS leaderboard」
风险点 1:独立抓取 Artificial Analysis TTS Leaderboard,前列是 Sonic 3.6 / Polly / Kokoro / Qwen-Audio-3.0-TTS-Plus / Inworld Realtime TTS-2——没有单独列 breezeblue。单源声明 + 不可印证,这个「#1」目前在客观证据上站不住。
风险点 2:breeze-tts-2 自己的 WER / CER / SIM / UTMOS 完全未公开。soniqo 那个 5 语种 FLEURS 独立复现榜是开源 TTS 圈最权威的第三方测评,breeze-tts-2 不在榜上——上榜的只有 VoxCPM2 / Fish S2 Pro / Qwen3-TTS Base / F5-TTS / IndexTTS2 / Higgs TTS 3 / Chatterbox / OmniVoice。换句话说,breeze-tts-2 没有任何第三方独立复现的客观质量数字。
同期对照(全部来自独立第三方)
| 模型 | en WER | zh CER | en Cosine | zh Cosine | 3090 RTF 中位 | 显存 |
|---|---|---|---|---|---|---|
| VoxCPM2 | 1.8% | 4.9% | 0.547 | 0.695 | 1.11 | 1.5 GB |
| Fish S2 Pro | 3.9% | 6.2% | 0.489 | 0.634 | 2.78 | — |
| Qwen3-TTS Base 1.7B | 2.4% | 5.7% | 0.491 | 0.701 | 1.70 | 1.8 GB |
| F5-TTS | 5.6% | 13.9% | 0.698 | 0.780 | 0.57 | 0.7 GB |
| IndexTTS2 | 5.1% | — | 0.738 | — | 1.0 | 2.9 GB |
| Higgs TTS 3 | 4.0% | 4.3% | 0.472 | 0.574 | 0.78 | 8.0 GB |
| breeze-tts-2 | — | — | — | — | H100 0.32(无 3090 数据) | 7.7 / 14.4 GiB |
数据来源:soniqo: Voice Cloning Models, Measured Across Five Languages
CosyVoice 3 的 自家测评表 给出 test-zh CER 0.81%(RL 版)/ 1.21%(base 版)——与人类基线 1.26% 持平甚至更低。Fish S2 Pro 自报 Seed-TTS WER zh 0.54% / en 0.99%——与 soniqo 复现存在矛盾(soniqo 测出 Fish S2 en WER 3.9%),差异来自参考集(Seed-TTS eval vs FLEURS)。
未解问题清单:
- 训练数据来源 / 规模 / 授权(README 全文未提)
- breezeblue-ai 团队 / 融资(X / Discord 在,但没有公开技术背书)
- 并发数字(issue #15 2026-09-05 提问,仍 open)
- LTS 计划(issue #11 2026-09-03 提问,仍 open)
- 3090 / 4090 / A100 实测 RTF(全空白)
值不值得跟(结合兴趣方向的判断)
直接给结论,按场景分级:
| 场景 | 是否推荐 breeze-tts-2 | 替代 |
|---|---|---|
| 206 已跑 VoxCPM2 + OpenMAIC | ❌ 无理由切换——vLLM-Omni 体系不共享、权重商用受限 | — |
| 「无参考 + 自然语言描述生成声音」(voice design) | ✅ 唯一开源选项 | 无直接对位(Fish S2 acting cues 需参考、Qwen3-TTS 走 ICL、VoxCPM2 voice direction 需参考) |
| 内部原型 / 学习 PyTorch 推理代码 | ✅ 可读 Apache-2.0 代码 | — |
| 任何商用 / 公开场景 | ❌ 权重非商用 + 商用必须订阅 breezeblue.ai | VoxCPM2 / CosyVoice 3 / Qwen3-TTS 闭源 API |
| 3090 极低资源「备用 TTS 备件」 | ⚠️ audio.cpp 6GB 路径可玩 | VoxCPM2 13GB |
| Mac 自托管 | ❌ 无 MPS / CPU 路径 | — |
| 多语种(>2 语) | ❌ 仅 EN + ZH | Fish S2 Pro(80 语)/ CosyVoice 3(9 语 + 18 中文方言) |
| 大并发服务 | ❌ 默认单并发、无 vLLM 路径 | VoxCPM2 vLLM-Omni / CosyVoice 3 vLLM |
| 强实时对话 + 流式 | ⚠️ 3090 数据空白 | VoxCPM2(206 已在跑,3090 RTF 0.23 已有实测) |
最终建议:
- 如果你是 breezeblue-ai 的目标用户(即认可 voice design 差异化、愿意为商用订阅付费、能接受 Python 原生部署),那 breeze-tts-2 是目前主流开源 TTS 中唯一无参考 voice design 选项——值得跟。
- 如果你的场景是 voice clone 优先(你只是想「用我的声音说一段话」),breeze-tts-2 没有任何客观质量优势,反而要绕开 vLLM 生态和商用限制——直接用 VoxCPM2 / CosyVoice 3。
- 如果你想给 206 加个 TTS 备件,audio.cpp 6GB 路径在 3090 上比 VoxCPM2 13GB 还省,是个有意思的备份思路——但要先在 3090 实测一遍(3090 数据完全空白)。
参考阅读
- breezeblue-ai/breeze-tts GitHub — 全部官方数字与版本线真源
- soniqo: Voice Cloning Models, Measured Across Five Languages — 最重要的第三方独立复现榜,breeze-tts-2 不在榜
- Artificial Analysis TTS Leaderboard — 官方声称的「#1」基准榜,独立抓取未发现 breezeblue 条目
- FunAudioLLM/CosyVoice — CosyVoice 3 完整测评表
- fishaudio/fish-speech — Fish S2 Pro 80 语种 + 自报 Seed-TTS WER 数据
- breeze-tts Issues — 第三方 audio.cpp 6GB / ComfyUI 集成 / 并发问题
- KB 深挖 [[voxcpm]] — 206 自托管现状真源(与 breeze-tts-2 商用对比)