每日文摘
深挖 · VoxCPM:想给 206 换的 TTS,其实正是已经在跑的那一个
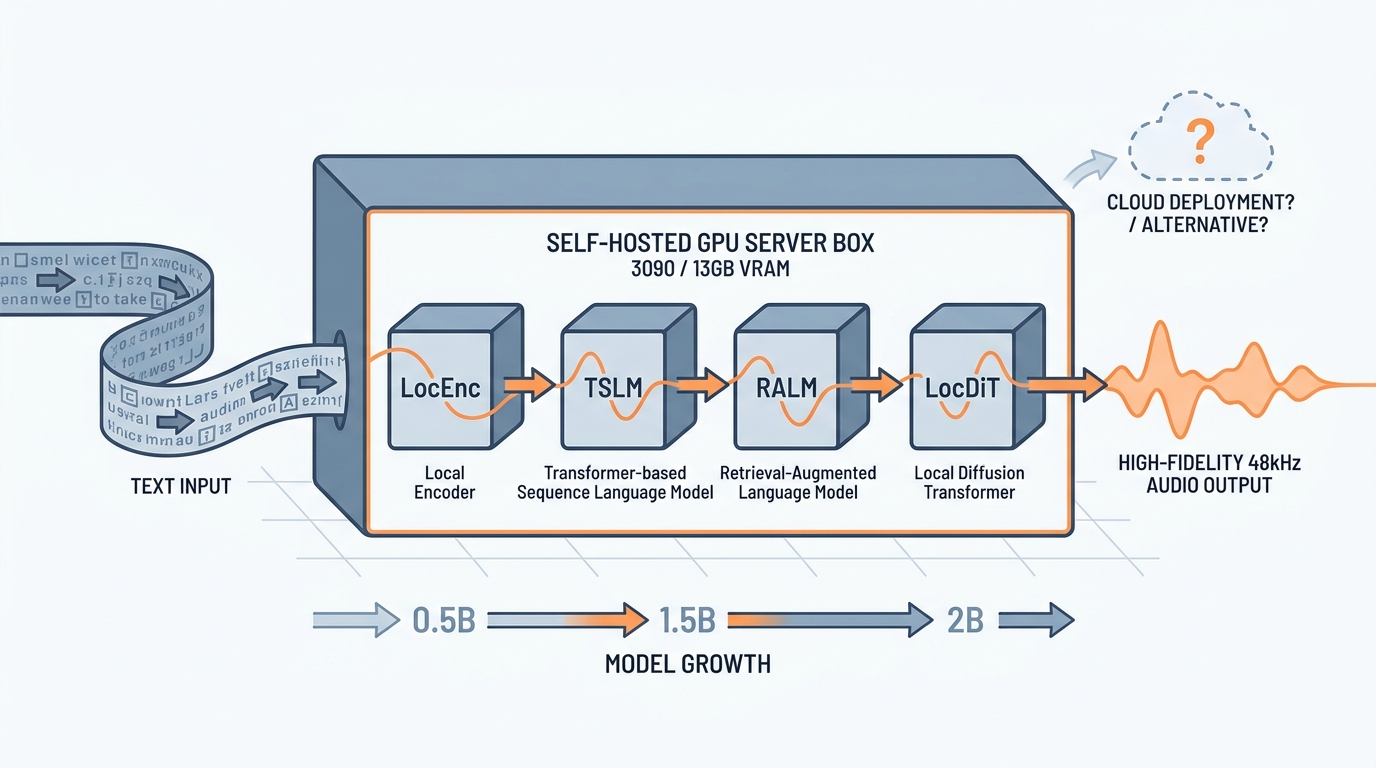
<本文由用户点名深挖:看到 VoxCPM 的介绍——2B 参数、Seed-TTS-eval 中文 CER 0.97%、RTF 0.30、8GB 显存——问「是不是比我 206 上现在用的 TTS 更好、更省资源,要不要 setup 起来搭配 OpenMAIC」。核实下来有个反转:这段介绍说的就是 VoxCPM2,而 206 上给 OpenMAIC 服务的 TTS 后端,跑的正是它。本文把这次「自己挖自己」的调研过程、一块 3090 上的一手实测,以及官方成绩单里的水分与干货,一次讲清。>
是什么
VoxCPM 是 OpenBMB(面壁智能 × 清华人机语音交互实验室 THUHCSI)的开源 TTS 系列,目前 37.4k star,代码和模型权重都是 Apache-2.0,明确可商用——这在开源 TTS 里是稀缺属性(F5-TTS 禁商用、Fish S2 Pro 的商用许可也要另议)。
版本线是三代:VoxCPM-0.5B(2025 年 9 月)→ VoxCPM1.5(2025 年 12 月)→ VoxCPM2(2026 年 4 月,2B、30 语种、16kHz 进 48kHz 出)。这里有个容易踩的坑:你看到的那些亮眼数字——2B 参数、200 万小时训练、中文 CER 0.97%/相似度 79.5%、英文 WER 1.84%、RTF 0.30(4090)、8GB 显存、GGUF 能上 M4 Pro——逐项对照后全部出自 VoxCPM2 的 README,跟初代 0.5B(180 万小时、16kHz 输出、RTF 0.17)没有关系。也就是说,那段介绍不是「新模型发布稿」,而是你现在就能在 repo 首页看到的现役成绩单。
然后是本次深挖的动机句:「看看 206 上 project 下在用的 TTS,有 openMAIC 内置的,以及 qwen-3.0」。上服务器核实的结果:
- OpenMAIC(docker,8391 端口)配置的 TTS 后端是
TTS_VOXCPM_BASE_URL=http://192.168.0.206:8392/v1,而 8392 端口上跑的进程是vllm serve openbmb/VoxCPM2 --omni——就是 VoxCPM2 本尊,9 月初部署、冒烟验证过,一直健康运行。 - 记忆里的「qwen-3.0」其实是 Qwen3.8-27B 本地 LLM(llama.cpp + GGUF,约 19.6GB 显存,和 TTS 分时共用一张卡),外加一个 qwen-asr 语音识别服务。都不是 TTS。阿里真正的 TTS 产品线 Qwen3-TTS(首包 97ms 那个)206 上并没有部署。
所以第一个问题的答案有点意外:不存在「换不换」,你想装的就是你在跑的,而且 repo 两周前(2026-09-02)还有提交,不存在「装了旧版」的问题。
核心机制(技术)
VoxCPM 全系的招牌是 tokenizer-free:传统 TTS 先把语音切成离散 token(类似文本 token),LM 逐个预测;VoxCPM 让语言模型直接在 AudioVAE 的连续潜空间里自回归生成语音表征,跳过离散化这一步,末端再用扩散解码器出波形——官方论文的说法是 “tokenizer-free TTS for context-aware speech generation”(arXiv:2509.24650,ICLR 2026)。
VoxCPM2 把这条路线做成了四阶段流水线:LocEnc → TSLM → RALM → LocDiT。前两级是语言模型活儿——TSLM(文本-语义 LM)规划韵律语义,RALM(残差声学模型)补声学细节,以 6.25Hz 的低速率吐连续 latent;后两级是 AudioVAE V2 的非对称编解码——编码器吃 16kHz 参考音频、解码器内置超分直接输出 48kHz,LocDiT 用 flow matching 去噪精化。底座 LM 是面壁自家的 MiniCPM-4,架构上致谢了 DiTAR(扩散自回归骨干)、CosyVoice(flow matching 实现)和 DAC(Audio VAE 骨干)——站在 CosyVoice 肩膀上,但走的是另一条路。
对使用者更实际的是三种音色玩法:Voice Design(用文字描述音色,不需要参考音频)、可控克隆(参考音频 + 风格指令)、Ultimate 克隆(参考音频 + 精确转写成对,保真最高)。参考音频 5–30 秒就够(官方文档)——你可能在介绍里看过「声音克隆需 5-10 分钟音频」,那是微调(SFT/LoRA)的口径,零样本克隆的门槛其实很低。
工程质量在开源 TTS 里算第一梯队:src layout、CI、Docker、测试文件、完整的微调训练栈,issue 有人清理、外部 PR 被合入。小瑕疵也有:gradio/funasr/modelscope 都是硬依赖,装起来偏重;README 版本表里 VoxCPM1.5 的参数量两处写了 0.6B 和 0.8B,自相矛盾。
怎么跑起来(环境)
四条部署路线,按「重→轻」排:
| 路线 | 命令/形态 | 显存 | 速度 |
|---|---|---|---|
| vLLM-Omni(官方生产路径) | vllm serve openbmb/VoxCPM2 --omni | ~13GB 地板 | RTF 0.12(4090 稳态) |
| pip 直装 | pip install voxcpm | ~8GB | RTF 0.30(4090) |
| nano-vllm-voxcpm(社区) | pip install nano-vllm-voxcpm | 灵活 | RTF ~0.13(4090) |
| llama.cpp GGUF | llama.cpp-omni | 最低 | RTF 1.76(M4 Pro)慢于实时 |
这里有个很多人(包括本次调研前的我)会困惑的点:官方说 8GB,为什么 206 上 vLLM 引擎进程实际占 13.1GB?答案是两套口径:8GB 是 pip 直装的数字;vLLM-Omni 服务化部署有 ~13GiB 的地板——权重约 4.9GiB,而扩散侧路径(LocDiT/AudioVAE/CUDA-graph 池)在 vLLM 的 KV cache 记账之外另行分配显存。官方部署 yaml 的注释写得很直白:“Keeps peak ~13 GiB on any card”。206 实测 13.1GB 与官方口径精确吻合——所以 --gpu-memory-utilization 0.2 已经压到底了,再调没有意义;真要省显存只能弃 vLLM 换 pip/nano-vllm(8GB 上下)或换 VoxCPM1.5(~6GB,但克隆模式少),代价是丢掉并发批量调度和流式服务化,对 OpenMAIC 场景不划算。
与 OpenMAIC 的关系也不用怀疑:这是官方内置适配,不是社区拼装。OpenMAIC README 有 “Optional: VoxCPM2” 专节,原话是 “OpenMAIC ships an adapter; run VoxCPM on your own hardware and OpenMAIC will talk to it”,给出三种后端,其中 vLLM-Omni 路径标注 “ideal for GPU servers”——206 上跑的正是官方首推组合。
然后是本次深挖最值钱的一手数据。全网上没有任何 3090 跑 VoxCPM2 的公开实测(官方只测 4090,社区实测集中在 2080Ti/3080Ti/L40),而 206 的 3090 就在眼前,直接测:
68 字中文文本 → 12.00 秒 @48kHz 音频,端到端耗时 2.77 秒(含 HTTP 往返),RTF ≈ 0.23。
这个数字有两个含义:一是 3090 + vLLM-Omni 的组合够到了官方量级(4090 稳态 0.12,3090 砍一半算力,0.23 完全合理);二是它推翻了此前知识库里「VoxCPM2 推理慢、不适合实时」的旧结论——RTF 0.23 意味着生成比播放快 4 倍多,单路流式完全可行。流式接口也是现成的:/v1/audio/speech 加 stream_format=sse 或 WebSocket 端点,官方口径首包 0.07–0.17 秒(4090/L40 单并发)。
对照组 Qwen3-TTS 也顺带查清了:它卖 97ms 首包 + 双轨流式,但官方 README 明说开权重版的 vLLM 支持目前"only offline inference, online serving will be supported later"——想要那个 97ms 实时体验,现阶段主要走 DashScope 云 API。OpenMAIC 里两条路都内置(TTS_QWEN_* 云 API / TTS_VOXCPM_* 本地端点),并不互斥。
数据说话(评测)
先给官方数字(README,注意全部是官方自报口径):
| 基准 | VoxCPM2 | 说明 |
|---|---|---|
| Seed-TTS-eval 英文 | WER 1.84 / SIM 75.3 | SIM 是强项 |
| Seed-TTS-eval 中文 | CER 0.97 / SIM 79.5 | 相比 v1 SIM 明显升、CER 略退(0.93→0.97) |
| MiniMax-MLS 多语种 SIM | 英 85.4 / 中 82.5 / 日 82.8 | 共享语言全部第一 |
| 弱势语言 WER | 阿拉伯 13.0 / 印地 19.7 / 罗马尼亚 21.6 | 官方如实列出 |
「多项指标超 ElevenLabs」的说法要打个折。溯源下来,那些数字全出自 README 里的 MiniMax-MLS-test 对照表:ElevenLabs 在泰语(WER 73.9)、越南语(73.4)、粤语(51.5)上确实崩溃,英语相似度 61.3 对 VoxCPM2 的 85.4 也确实是表里数字。但——中文 README 原文只说 “SOTA or comparable”,没有「超越」字样;表里没注明 ElevenLabs 用的是哪个模型版本、SIM 用哪个打分器;也没有盲听复核。第三方 soniqo 的复现给了反方向证据:5 语种 FLEURS 克隆基准里,VoxCPM2 的相似度没有一个语种排第一(英文 0.547 vs IndexTTS2 的 0.738,中文 0.695 vs F5-TTS 的 0.780),UTMOS 音质分也普遍低于 Fish S2 Pro 和 Qwen3-TTS。同一张官方表里还有个冷知识:错字率维度它并不占优——Fish S2 英文 0.99/中文 0.54、Qwen3-TTS 1.23/1.22,都比 VoxCPM2 好。
RTF 则是一场口径罗生门,值得单独说:
- 官方:0.30(4090,PyTorch 直推)/ 0.12(vLLM-Omni 稳态)
- 知乎实测:1.5–2.0(pip/API 部署),结论「不足以实时」
- soniqo:1.09–1.18(硬件未注明)
- 本次 206/3090(vLLM-Omni):0.23
拼起来看规律很清晰:测出 1 以上的,基本都是 pip 直装或 API 单进程口径;走 vLLM-Omni 服务化的,都能进官方量级。不能简单说官方虚标,但「用什么方式部署」对速度的影响比换显卡还大。
负面反馈也要如实摆:长文本稳定性是真实短板(15 分钟讲稿分句合成,10+ 次声音漂移、2 次情感突变,换 seed 重试解决);克隆偶发翻车(#191 中途换成另一性别的声音并混入背景噪声、HF 讨论 #3 语速 2–3 倍异常——后者归因是参考音频采样率);跨语克隆带口音,配音转译场景不推荐。口碑两极:波兰语克隆「best」的评价和法语参考音频「pretty bad at cloning」的评价同时存在。
值不值得跟(结合兴趣方向的判断)
回到最初的两个问题,现在可以给完整答案:
一、是不是比 206 现有的更好、资源更小? 你看到的成绩单就是 206 正在跑的 VoxCPM2 的成绩单,不存在「更好的新版」。资源占用上,13.1GB 是 vLLM-Omni 服务化的显存地板(官方注释背书),压不下去;好消息是实测 RTF 0.23,比预期快得多,「只适合非实时」的旧判断可以撤了——它现在既能做课前批量预生成,也能撑单路课堂流式。
二、要不要 setup 搭配 OpenMAIC? 已经搭配在跑,而且是官方钦定路径。真正值得做的增量是三件小事:①课堂实时问答链路把 /v1/audio/speech 切到 stream_format=sse 流式;②用 precompute_custom_voice.py 把克隆音色预计算(206 上已有 profile test1),免去每请求重编码参考音频;③如果未来要「可打断、极低首包」的强实时对话,再补一路 Qwen3-TTS 的 DashScope 云 API——OpenMAIC 里两条路本来就是并列设计。
通用一点的教训也记下了:点名评估一个「新模型」之前,先盘点自己服务器上已经部署了什么——这次要是直接开调研,很可能得出「推荐部署 VoxCPM2」的结论,然后发现它已经跑了半个月。另外,第三方实测和官方数字差 5 倍的时候,先看部署方式再看硬件,pip 直装和服务化的差距经常比 3090 和 4090 的差距大。
参考阅读
- OpenBMB/VoxCPM README — 全部官方数字与版本线的真源,弱势语言也如实列出
- vLLM-Omni VoxCPM2 recipe — 4090 显存分解与稳态 RTF 0.120 的完整实测过程
- vllm_omni/deploy/voxcpm2.yaml — “peak ~13 GiB on any card” 显存地板的官方注释
- soniqo: Voice Cloning Models, Measured Across Five Languages — 对官方口径最重要的第三方反证
- 知乎:经实际测试 VoxCPM2 不足以用来实时语音合成 — pip 口径 RTF 1.5–2.0 与长文本漂移实录
- THU-MAIC/OpenMAIC README — 官方 VoxCPM2 adapter 与三种后端
- pinggy: Best Open Source Self-Hosted TTS Models in 2026 — 2026 自托管 TTS 场景化推荐
- arXiv:2509.24650 — tokenizer-free 架构技术报告