每日文摘
深挖 · turbovec:17.1k star 的 Rust 向量库,16× 压缩内存但别急着替换 FAISS
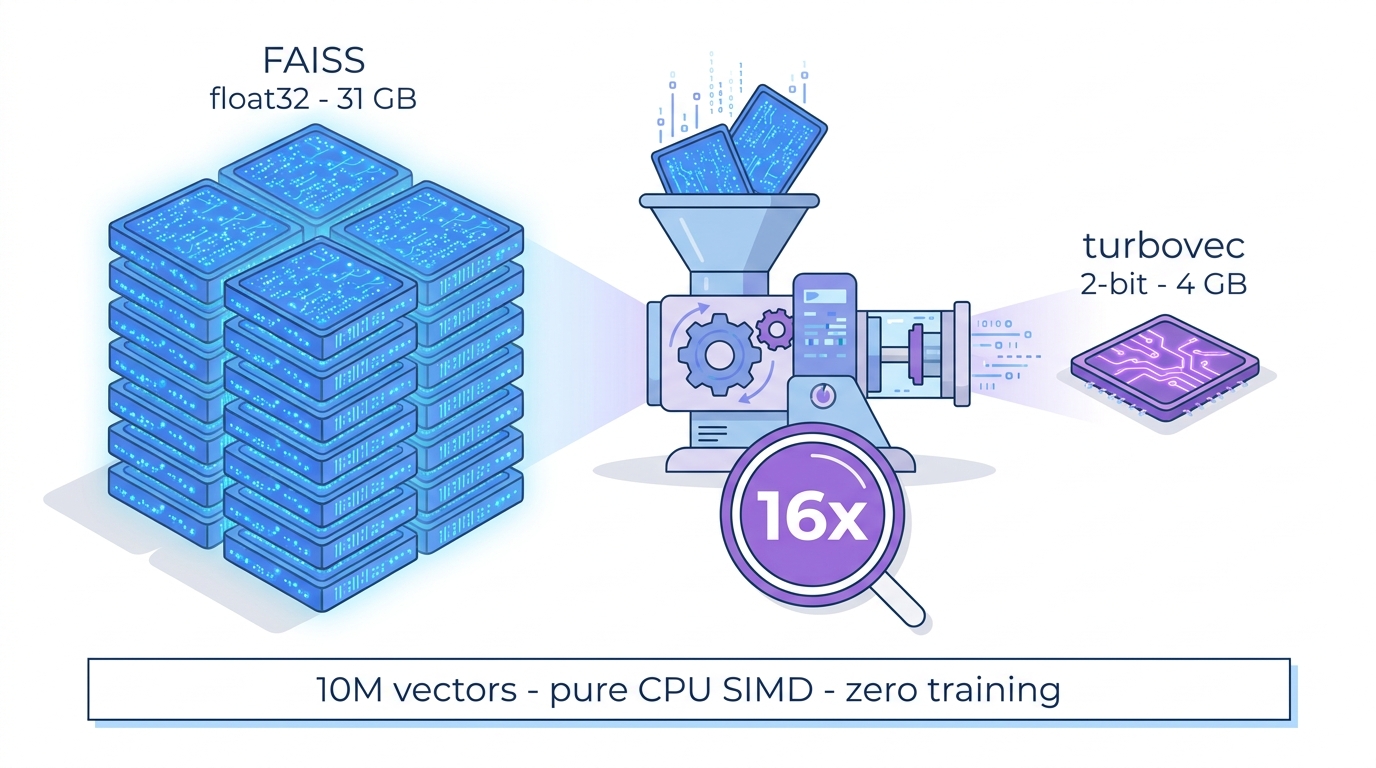
如果你用 FAISS 存过人脸向量,最近大概率刷到过 turbovec——一个半年拿下 17.1k star 的 Rust 向量索引库,宣传语直接写着「FAISS was the standard. turbovec makes it obsolete」。10M 条向量,float32 要 31 GB 内存,它说 4 GB 装下,还附赠一组「比 FAISS 快 3.4×」的基准图。
先说结论:它不是 FAISS 的替代品,而是另一种东西——把向量极限压缩后穷举扫描的专用工具。人脸识别这类需要精确 top-1 的场景,不该换;但它在某个细分生态位上确实有真本事。下面拆开看。
是什么
turbovec 是一个 Rust 编写的向量索引库,带 Python 绑定,MIT 协议。2026 年 3 月 26 日建库,到现在(9 月中)17.1k star、1.5k fork——但实质是单人项目:7 个贡献者里作者 RyanCodrai 一个人贡献了 362 个 commit 中的 351 个(GitHub API)。作者 LinkedIn 显示 Applied AI @ Anthropic(个人项目,与 Anthropic 无关)。
它的底层算法不是自己发明的,而是 Google Research 的 TurboQuant 论文(arXiv:2504.19874,自称 ICLR 2026)的开源实现。招牌卖点一句话:2-bit 量化,16× 内存压缩,免训练,纯 CPU SIMD 打分比 FAISS 的 PQ FastScan 还快。
但有个容易被宣传语掩盖的定性:turbovec 只有穷举扫描,没有 ANN 结构。没有 IVF 倒排,没有 HNSW 图,没有 GPU,也没有精确搜索模式。它是「把全库压到极小,然后用 SIMD 快速扫完每一行」的路线——这决定了它所有的强项和边界。
核心机制(技术)
TurboQuant 的量化流水线六步(README):
- 归一化:每个向量剥离范数另存一个 float,只剩单位方向;
- 随机旋转:全体向量乘同一个随机正交矩阵,旋转后各坐标分布趋近高斯——与输入数据分布无关,这是「data-oblivious」的关键;
- 可选校准(TQ+):turbovec 自有增强,对每个坐标拟合 shift+scale,采样约 1024–2048 行即可,R@1 最多 +2.2pp。注意文档原话:样本有偏会「actively destroys recall」且无法靠重拟合修复;
- Lloyd-Max 标量量化:2-bit 分 4 桶、4-bit 分 16 桶,量化边界是从数学算出来的,不是从数据学出来的;
- 位打包:1536 维向量从 6,144 字节压到 384 字节(2-bit),这就是 16× 的来源;
- 范数校正打分:每向量存一个校正因子,进堆前乘回,让内积估计无偏——这一步「adapted from RaBitQ」,后文会讲这个借用的讽刺之处。
与 FAISS PQ 的本质差异在第 4 步:IndexPQ 需要 k-means 训练码本,TurboQuant 完全免训练,向量来了就能流式编码,论文称「indexing time virtually zero」。
索引只有两种:TurboQuantIndex(槽位号)和 IdMapIndex(稳定 uint64 外部 id,O(1) 删除)。查询时对全库 SIMD + 查表打分取 top-k,延迟随库规模线性增长。allowlist 过滤在内核里按 32 向量块短路,整块无候选直接跳过查表。SIMD 内核分三条路径(ARM NEON SDOT/SMMLA、x86 AVX-512 VNNI、AVX2 回退),运行时检测自动选择——有意思的是,x86 内核的打包布局直接改编自 FAISS FastScan,算是把对手的刀拿来用了。
工程质量呈两极。好的一面:38 个集成测试、12 个 CI workflow(包括变异测试),这个测试密度在单人项目里罕见。坏的一面:PyPI 自评 Development Status「3 - Alpha」;序列化格式半年演进到 v7,v1–v4 的旧文件已不可解码;更实际的坑是文件没有 payload 校验和——docs/api.md 自曝实验中 96% 的位翻转会被静默加载成一个不同的索引,不报错。
怎么跑起来(环境)
pip install turbovec,零运行时依赖,一个 abi3 轮子覆盖 Python 3.9–3.13+。官方轮子覆盖 macOS ARM、Linux x86_64/aarch64、Windows x64——Apple Silicon Mac 是一等公民(NEON 路径),Linux 老到 glibc 2.28 都行。
GPU:没有,也没有路线图。 README、依赖表、issue 区都搜不到任何 GPU/CUDA 痕迹。也就是说如果你有台 3090 机器,turbovec 一个晶体管都用不上——它只吃 CPU。这对人脸识别老用户是个直接的心理落差:FAISS 的 GPU 检索(faiss-gpu/cuvs)当年可是硬需求。
从 FAISS 迁移的概念成本低、签名成本高:IdMapIndex ≈ IndexIDMap,都有 add_with_ids 和按 id 删除,但 id 是 uint64(FAISS 是 int64)、输入必须是连续 2-D float32(其它 dtype 直接拒绝)、返回的分数是内积越大越好(FAISS L2 越小越好,阈值逻辑要整个反过来)。没有任何 FAISS 互转工具,迁移 = 从 FAISS 导出原始向量 → 逐批 add_with_ids 重建,且量化有损,不存在无损导入。
度量上有个值得记住的等价性:turbovec 只做「范数校正的内积」,没有 L2 参数。但归一化向量上,cosine、内积、L2 三者严格同序——所以 ArcFace 这类标准做法(L2 归一化 + 余弦)下排序语义等价;只有「未归一化 + L2」的场景不等价。
两个真亮点:sync(path) 增量持久化,每次调用恰好一次 fsync、双 commit header 防撕裂写入,小量追加「无论索引多大都是毫秒级」;以及微秒级删除——remove 0.44–1.37 µs,而 FAISS IndexIDMap 的 remove_ids 单次要 0.19–1.02 秒(100K 时需重排全部码)。对「向量频繁增删」的场景,这是数量级的差异。
框架集成给得很全:langchain / llama-index / haystack / agno 四个 extras,drop-in 替换各自的 InMemory store,换 import 不换管线。共性限制:不支持 MMR、原始向量不可恢复(量化后就扔了)。
数据说话(评测)
官方基准(README):100K 向量、1K 查询、k=64、5 次取中位。4-bit 平均比 FAISS IndexPQFastScan 快 3.4×(ARM 3.5×、x86 3.4×),2-bit 快 20–26%;召回上,2–4 bit 的 turbovec 与 8-bit 的 FAISS IndexPQ 同档或略优(R@1 +0.9–2.9pp,个别配置输 0.7pp)。写入侧单条 add 6.3–19.7 µs,快 7.6–13.9×。
但这些数字有几个必须知道的口径问题:
第一,README 没有任何绝对 QPS/延迟数字,全是相对 FAISS 的倍数。而库规模只测到 100K——「10M 文档 4GB」是内存声明,不是实测基准。穷举扫描延迟线性增长:第三方实测(Infino)100K→933K 延迟 1.59→19.05 ms,线性外推 10M 单查询约 200–270 ms(外推,非实测)——对在线服务基本不可用。
第二,对比对象只有 FAISS 的 PQ 系,没有 IVF、没有 HNSW、没有 usearch。HN 评论直接指出「FAISS PQ is no longer close to SoTA」。而且「always faster than FAISS」这句被第三方证伪:2-bit 多线程配置(d=1536/3072)实测比 FAISS 慢 2–4%(Pebblous、Infino);「31GB→4GB」的 31GB 只在 768 维假设下成立,README 同页用 1536 维算压缩比,1536 维的 float32 应为 61GB;那张删除延迟对比图用的是 log 尺度。
第三,作者自己在 issues 里比 README 诚实得多(均为作者本人 filing):
- #370:召回优势依赖真实 embedding 的各向异性——在各向同性高斯数据上输 FAISS 1.0–9.7pp,作者原话「headline claim reads as universal and isn’t」;
- #310:bimodal 分布 2-bit R@1 0.364 vs FAISS 0.632,one-hot 类差 4.5×,「beats FAISS 只在 dense unimodal embedding 上评过」;
- #332:查询侧 LUT 被量化到 7-bit,召回代价 1.5–3.5pp;
- #336:并发天花板——14 线程读扩展只有 2.42×,n=8192 处有未记录的延迟悬崖,单个后台 writer 会打掉读吞吐 40–50%。
第四,底层论文正在打学术争议官司。 RaBitQ 作者方(NTU 团队)的技术报告(arXiv:2604.19528)称多数设置下 TurboQuant 差于 RaBitQ,且论文的 runtime/recall 数字无法在其发布实现下复现;OpenReview 上有学术不端指控(HN 转述,原帖未能直接核验)。讽刺的交叉点是:turbovec 用来做无偏打分的范数校正,借用的正是对手 RaBitQ 的方法。
第三方横评里最有参考价值的是 Sean Pedersen 的独立基准(arXiv embedding,d=256,100K):turbovec 4-bit R@10 0.880 / p50 2.37 ms / 索引仅 13.4 MiB / 构建 0.6 秒——是所有参赛者里的「存储与构建时间离群值」;同一测试里 zvec 的 HNSW+RaBitQ 召回 0.964 @ 1.15 ms,召回和延迟都更好,代价是索引大 11×。他还验证了一条补救路线:turbovec + FP16 rerank top-100 后 R@10 直接到 1.000,延迟只加 2%——但前提是你得留着原始向量文件。
值不值得跟
回到原始问题:人脸识别(1:N 比对、ArcFace 嵌入、要求高召回 top-1)能不能用 turbovec 替换 FAISS?不能。 三个硬伤:一是没有精确模式,4-bit 召回上限约 R@1 0.97,意味着约 3% 的漏配率,叠加 LUT 7-bit 和校准损耗更糟,人脸比对通常不可接受;二是 512 维 ArcFace 的类簇分布没有任何公开实测——所有基准都在文本 embedding 上跑,最接近的 proxy(作者自己 issue 里的 clustered 数据)2-bit R@1 只有 0.080;三是并发坑(#336)对在线服务是现实风险。FAISS 的 IndexFlat(精确)或 HNSW(高召回可调)加 GPU 路径,仍是这个场景的对口答案。
那它的真实生态位在哪?内存极度受限、能接受量化召回或自管 rerank、向量频繁增删、需要 allowlist 过滤式检索的本地/嵌入式场景。典型画像:一台小内存机器上跑本地 RAG,几十万到百万级文档,CPU-only,不想为向量单独起 Qdrant/Milvus 服务——pip install turbovec 换掉 langchain 的 InMemoryVectorStore,内存省一个数量级,删除是微秒级。注意 PyPI 自评 Alpha + 单人维护,生产采用请保留回退路径。
作为知识储备,还有两条值得记:一是 TurboQuant 代表的「免训练量化」路线与 RaBitQ 的之争,是当前向量量化领域的活教材(RaBitQ 已被 FAISS 等主流库广泛采用);二是 Qdrant 已经集成 TurboQuant 做非 fp32 存储——算法本身的生命力,可能比这个 repo 更长。
参考阅读
- turbovec README — 官方机制、基准与限制的一手真源
- TurboQuant 论文 — 算法原始出处(Google Research)
- NTU 对比报告 — RaBitQ 方的复现争议,评估可信度前必读
- Sean Pedersen 独立基准 — 目前最独立的横向实测,含 rerank 补救方案
- Infino 横评 — 唯一带绝对延迟数字的对比(厂商自评,打折读)
- Pebblous 事实核查 — 对 README 宣传口径逐条核查
- issue #370 — 作者本人对召回口径局限的自曝,比 README 诚实
- HN 主帖 — 社区正反面声音全集