每日文摘
深挖 · AgeVal:浙大开源的 coding agent 评测底座,评的不是模型,是跑起来的整个 agent
<本文由用户点名深挖:想知道这个项目的主要目标、有什么用处、对我们的开发有什么启发、有没有能用上的场景。结论先行:它是一个值得「抄思想、轻试用」的评测底座——架构设计是近期同类里最讲究的,但 Hub 榜单数字目前只能当项目自述看。>
是什么
AgeVal 是浙江大学 REAL Lab 开源的 coding agent 评测运行时(harness),2026-08-02 建仓,MIT 协议。先把名字里的歧义去掉:它不是 Amazon 那个评数学推理的 AgentEval,也不是各种同名 AgEval——目前无论文无引用,是纯工程开源项目(arXiv 上同名项目均与本仓库包结构不符)。
它的核心主张写得很直白:评的不是模型,是「跑起来的整个 agent」。lm-eval-harness 那一代评测评的是模型输出(prompt → text + 静态指标),而 AgeVal 的被测对象是「agent 运行时 × 模型 × 执行环境」的三元组合——被测 agent 默认通过 ACP 协议接入(pi、Codex、Claude Code、OpenCode 都行),NVIDIA 的 nooa、DeepSeek 自家的 dsh、mini-SWE-agent 则作为插件走同一条路径。口号 “Write your agent eval once. Run it anywhere.":同一份数据集,换 agent 改一行配置,换环境再改一行。
这个定位瞄准的是评测界一个真实痛点:同一套模型,换个 coding agent 运行时,测试得分和实际消耗往往大相径庭;而为每个「运行时 × 模型 × 环境」组合重写评测脚手架,是写不完的胶水代码。出品团队也确实有评测基因——REAL Lab(方向是 Reasoning / Embodied / Agentic / Lifelong-learning AI)的 PI 沈永亮是 HuggingGPT 和 TaskBench(NeurIPS 2024,agent 任务自动化基准)的一作,org 下还有 KnowU-Bench、VerifyBench、PaperGym 一整条评测产线。AgeVal 可以看作这条产线从「论文配套一次性代码」到「可复用基础设施」的升级。
体量与状态要有数:6 周 1329 commits、PyPI 周更(ageval-cli 0.7.1→0.8.0)、README 双语 + 独立 ARCHITECTURE.md,工程节奏非常快;但 54 stars / 0 fork、贡献者仅 2 人(ffy6511 占 99%),issue 区限制外部创建——目前是一个「高素养的单人主力新项目」。
核心机制:把评测的老毛病变成架构约束
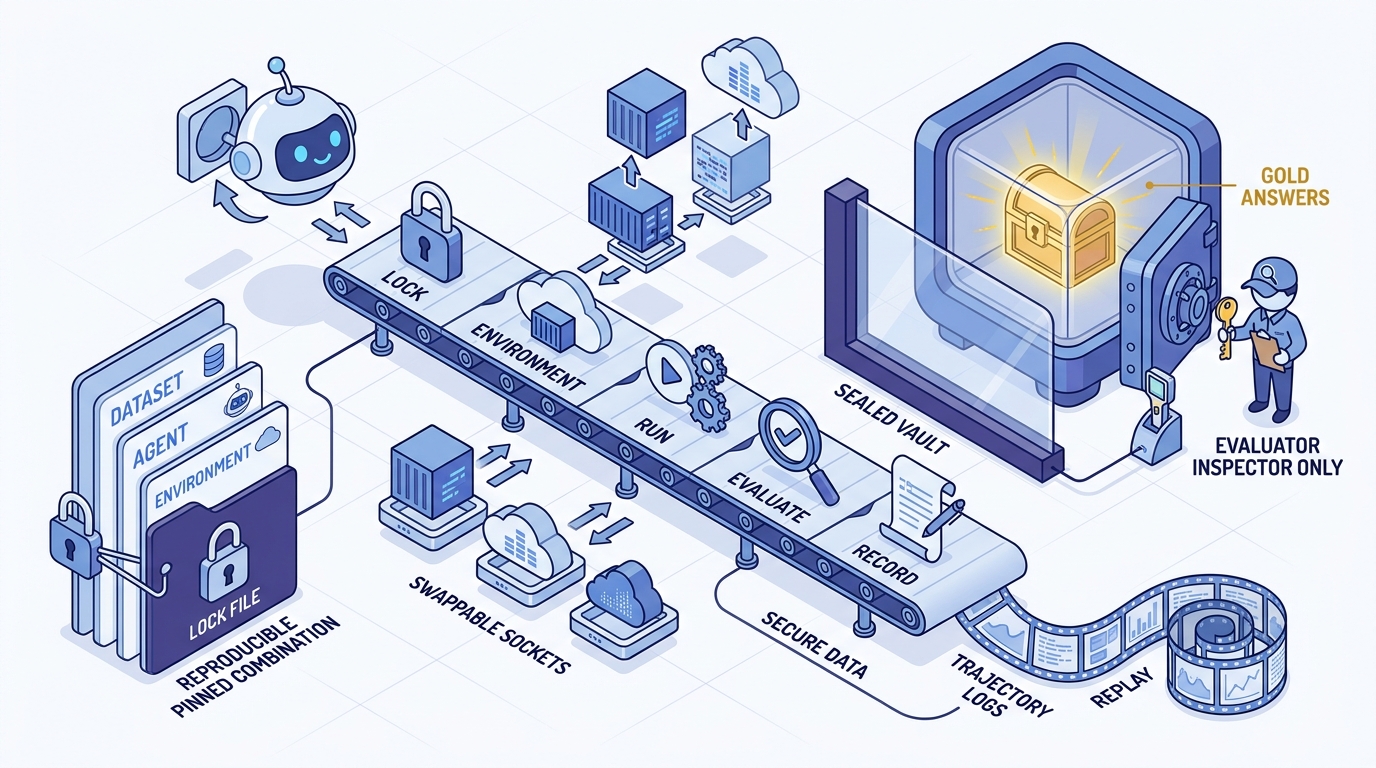
AgeVal 把一次评测固化成五阶段流水线:lock → environment → run → evaluate → record(ARCHITECTURE.md)。三个设计值得细看,因为它们分别对应评测界三个老毛病:
老毛病一:换了个组合,分数就不可比。 AgeVal 的解法是 ageval lock:解析插件依赖图后产出 lock.json,把 dataset × agent × environment 的组合连同 digest 钉死,可重放、不含明文密钥。凭什么能力不匹配(缺凭据、缺插件)直接在 lock 阶段失败,run 永不启动——「榜单可比性」在这里变成机制而不是自律。
老毛病二:agent 偷看答案。 AgeVal 把它从纪律问题变成结构问题:gold 数据在 run 阶段不挂载,evaluate 阶段才上传;PASS 判定权只属于数据集自带的 evaluator.py(“Only evaluator.py can return PASS”),评分容器甚至可以 network: none + 第二隔离宿主;cleanup 在所有退出路径必跑,超时判 FAIL(0)、evaluator 崩溃判 ERROR,分数一旦绑定不可再改。
老毛病三:跑完只给一个分,卡在哪一步无从追溯。 每次 run 落盘证据三件套:lock.json(可复现锁定)、result.json(状态/分数/日志)、trajectory.jsonl(完整轨迹),配 ageval view 本地回放——各阶段耗时、工具调用、失败任务的复现命令都在。
插件哲学也说得斩钉截铁:“Write a plugin for ageval; do not fork it”。官方举证是 DeepSeek 的 harness 以插件进入、“zero lines changed in ageval”。环境侧同样五选一插拔:local / Docker / E2B / Daytona / SSH。
最后一个差异化设计最有意思:让 coding agent 自己当评测作者。装上技能包(npx skills add ZJU-REAL/ageval)后,pi/Claude Code 这类 agent 可以自己编写、移植数据集并端到端跑评测——把「构建评测」这件事本身也 agent 化了,同类框架里没有这个一等公民入口。
放到谱系里看:lm-eval-harness(约 14k★)评模型静态能力,DeepEval(约 18k★)做 LLM 应用的 pytest 式单测,AgentBench / LiveBench 是固定任务集的基准本体,HELM 已宣布维护模式,OpenAI evals 官方投入收缩。AgeVal 卡的是「harness 层」——想成为 agent 评测界的 lm-eval-harness,且把三个变量全部做成可插拔,这个卡位目前没有直接竞品。
怎么跑起来
- 安装:
uv tool install ageval-cli,一条命令。Python ≥3.12 由 uv 自动托管,核心运行时依赖只有三个(pyyaml / typer / agent-client-protocol),E2B/Daytona 等按需装 extras。 - 硬件:零 GPU 要求。AgeVal 不训练不加载模型,是纯评测编排层,被测模型全部走远端 API——你那块 3090 在这里没有用武之地,除非把自托管推理端点接进来(见下)。
- 模型接入三条路:ACP executor(agent CLI 自带,官方默认示例就是智谱
zai-coding-cn/glm-5.3+ZHIPU_API_KEY);openai-httpexecutor 直连 OpenAI 兼容端点——base_url是配置的一等字段,官方示例指向智谱端点;nooa 插件走 LiteLLM。接 vLLM/Ollama 在字段层面完全可行,但官方文档没写这两个词,属推断,需实测。 - 真实门槛两处:一是被测 agent 必须有模型 API key,缺凭据直接 fail-closed(“no mock executor”);二是内置 minimal-demo 默认 Docker 环境、需要本地装 Docker,而 tau3-airline-5 默认 local 零外部依赖。跑之前
--probe可以预检。 - 数据集不用手动下载:
ageval run official/minimal-demo@0.1.3 --task terminal-jsonl-agg从 Hub 自动拉取,内置 7 个 agent 模板(cc/codex/dsh/miniswe/nooa/opencode/pi-default)开箱即换。 - 成本:官方没有给出任何 token/时长数字;Hub 按 model 跟踪 cost,跑完
trajectory.jsonl可自查。真正花钱的是被测 agent 背后的模型 API 调用。
数据说话
好消息和冷水都要如实端上。
数据集:Hub 上 6 个官方数据集全部是既有公开基准的移植,无一原创(Hub API 实测):humaneval 164 题、deep-swe 114 题(上游 113,差 1)、tau3-airline 50 题、tau3-retail 114 题(上游 τ²-bench 论文为 115,差 1)、tau3-telecom 114 题、terminal-bench-2 89 题。移植溯源做得规范——数据集声明里带 upstream commit、论文链接和已知差距(“not bit-identical tau2 CLI runner”),主动坦白好于多数同类。
榜单要泼的冷水:截至 2026-09-14,Hub 榜单 19 条结果全部由项目成员 ffy6511 一人上传;每 task 仅 1 次采样(无重复实验、无置信区间);只覆盖 5 个国产模型(DeepSeek-V4-Pro、Qwen3.8-Max、GLM-5.2、Kimi-K2.7-Code、MiniMax-M2.7),没有 GPT/Claude/Gemini;humaneval 榜 0.86–0.994 已近饱和(2021 年基准,训练语料高危污染区);deep-swe 还出现 pass_rate 0.474 与 mean_score 0.909 并存、评分口径未说明(Hub suites API 实测)。自报结论里能看的只有相对对照:Qwen3.8-Max 在多数有对照的数据集上优于 DeepSeek-V4-Pro(tau3-airline 域 DeepSeek 0.820 反超 0.800),GLM-5.2 在 humaneval 单项最高(0.994)。
社区检验:54★ / 0 fork / 0 watcher,issue 区 12 条全是作者的内部任务追踪且限制外部创建,Hub 第三方下载量仅 1 次,零第三方实测、零复现、零公开质疑;中文报道(量子位通稿 + 知乎 + 搜狐转载)均无评测数字,英文社区(HN/Reddit)零讨论。要强调的是:没有质疑 ≠ 经受住检验,是项目太新太冷门、检验尚未发生。项目自己的态度倒也克制——设计文档反复强调 Hub 榜单是「观测,不是 PASS」,ARCHITECTURE.md 自评当前证据等级为 runnable-mvp,并写明架构图「不要当作已交付」。
值不值得跟
回到点名时的三个问题,给一个直答。
主要目标与用处:解决「换 agent 运行时分数大变、组合爆炸反复写脚手架、跑完只有笼统分数无法追溯」三个评测痛点。它最有用的形态不是「去看它的榜单」,而是「用它跑自己的评测」。
对我们开发的启发(这是比工具本身更稳的价值):
- 评测架构思想可以直接抄:lock 钉组合保可比、gold 与被测物物理隔离、证据三件套可回放、插件化别 fork——这四条搬进自己的回归脚本和 CI,哪怕 ageval 明天消失也成立。
- 「评整个 agent」的视角值得切换:选型 coding 模型时,模型榜(Arena、lm-eval)只是半个答案,另一半在运行时与环境的组合上——这正是 pi/Claude Code 用户日常体感与榜单不符的结构性原因。
- 让 agent 自写数据集的 skills 模式与日常 coding agent 工作流天然咬合,是「评测构建 agent 化」的早期样本。
可用场景(结合个人开发者、3090、自托管偏好):
- 场景一:coding 模型/网关横评,现在就能做。 拿 tau3 或 terminal-bench-2 的移植包,
openai-http接 GLM/DeepSeek 的 key,同一数据集换模型自跑自比——比看任何二手榜单都可靠,ageval view还能回放每个任务的卡点。 - 场景二:给自己的 agent 化管线建回归测试。 用它的数据集格式(
tasks/<id>/内 task.yaml + run.py + evaluator.py)给 DailyNews 这类管线写几道小任务,改 prompt/skill 后跑回归,lock 保证前后可比。这比引入一个 6 周的新框架更轻的做法是只借格式。 - 3090 自托管推理(vLLM/Ollama)接入属「字段支持、未验证」,想省 API 钱的可以先拿 minimal-demo 实测一晚。
总判断:54★、6 周、单人主力、生态为零、0.8.x 周级变动——按「star 数当警告标签读」的纪律,现在不宜把它当依赖;但它的架构设计是近期同类开源里最讲究的一档,当「可试的工具 + 可抄的思想」正合适。等它配出论文、有第三方复现、Hub 出现非项目成员的上传者,再考虑深度接入不迟。
参考阅读
- ZJU-REAL/ageval 仓库 — 真源:双语 README + quickstart 五条命令
- ARCHITECTURE.md — 五阶段流水线、插件机制、工程纪律的最权威描述
- ageval 官网/文档站 — 定位论证、FAQ(“Write a plugin; do not fork”)、Agent-driven 评测章节
- ageval Hub — 数据集/榜单/Agent 市场(JS SPA,生产 API
/v1/*可直接读) - 智源社区转载量子位通稿 — 官方口径的三大痛点叙述,无评测数字
- τ²-bench 论文 (arXiv:2506.07982) — tau3 三域移植的上游基准
- DeepSWE 数据卡 — deep-swe 移植上游(任务数差 1 的对照点)
- EleutherAI/lm-evaluation-harness — 谱系对照:AgeVal 想成为的「agent 界 lm-eval-harness」