每日文摘
深挖 · teamai-cli:腾讯开源的团队 AI 资产集线器,一个 git 仓库喂饱全队的 11 种 agent
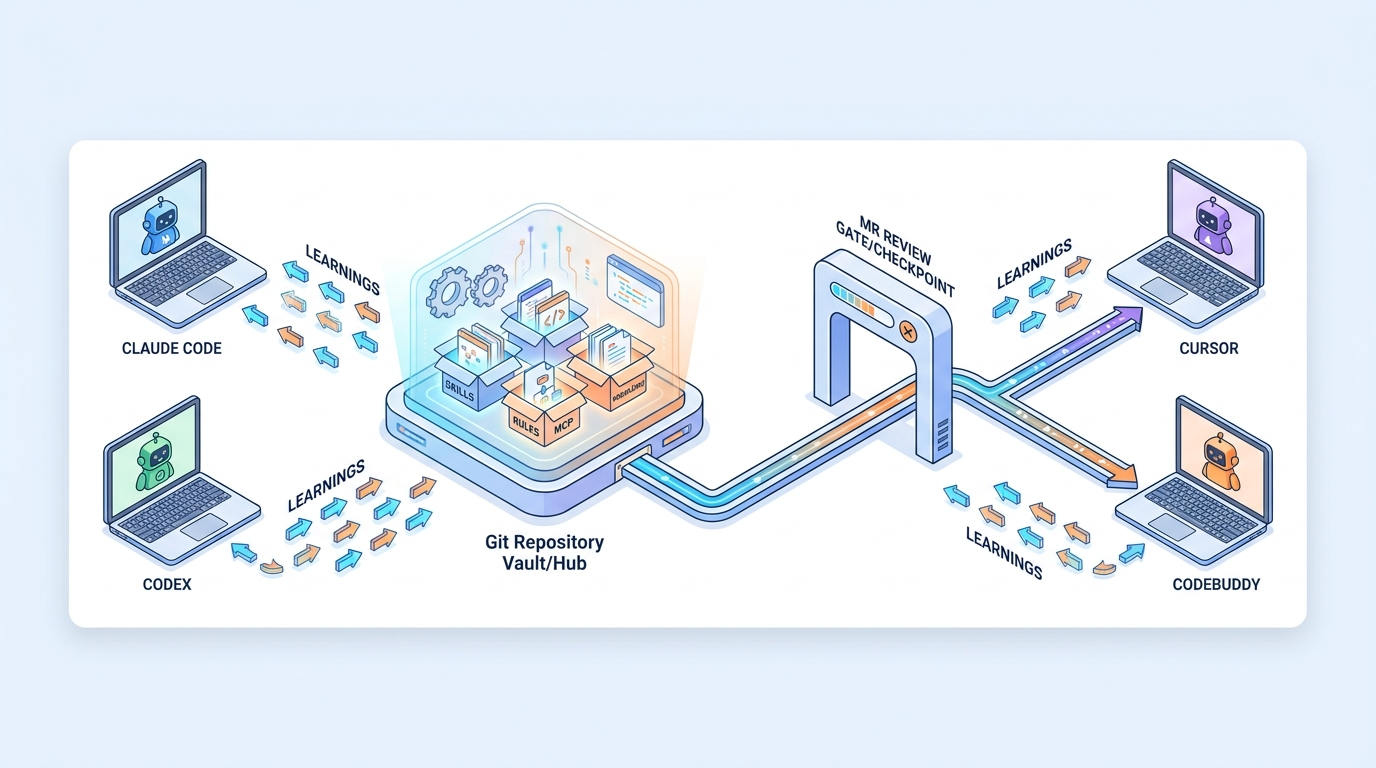
团队里有人用 Claude Code、有人用 Cursor、有人用 CodeBuddy,每人手里都攒着一撮好用的 prompt、skill 和踩坑经验——然后呢?散落在各自的 ~/.claude/ 和聊天记录里,人走了经验就没了。腾讯最近开源的 teamai-cli 冲的就是这个问题:用一个共享 git 仓库,把团队的 AI 资产统一沉淀、评审、分发到 11 种编码工具。star 三周从 389 涨到 2979,但 npm 周下载只有 1315——这中间的落差,正是本文要拆的。
是什么
先把最常见的误会澄清掉:teamai-cli 不是又一个 AI 编码工具,它不接任何模型。它的口号是 “Make Every Team AI Native”,定位是横跨多种 AI coding agent 的「团队配置与知识分发层」——把团队的 skills、rules、MCP 配置、hooks、知识文档集中到一个共享 git 仓库,经 MR 评审后自动分发到每个成员本地装的所有 AI 工具(README)。
产品分三层(README):
- Team Execution(已稳定):init/pull/push、skills、rules、agents、hooks、MCP——让每个 agent 按团队的方式干活;
- Team Context(beta):recall 经验召回、learnings、codebase graph——让 agent 理解团队;
- Team Improvement(beta):friction 经验回流、digest、dashboard——让每次执行反哺团队。
兼容矩阵覆盖 11 种 agent:Claude Code、Codex、Cursor、CodeBuddy、WorkBuddy、OpenCode、OpenClaw、Hermes、DeepSeek Harness、Qoder、ZCode(README 中文版)——Claude、OpenAI、国产路线全都在列,成员可以各用各的 agent,资产照样统一。一个小提醒:中英文 README 的名单不完全一致(英文版列 9 个),社区也建议引入前按自己的工具组合实测(zhangferry 评测)。
它和 Claude Code、Cursor 是互补而非竞争:Claude Code 本身就是 teamai-cli 的分发目标之一。它管的是各工具的配置注入点(hooks、CLAUDE.md/AGENTS.md、MCP 配置、子 agent 文件),自己不做编码 agent 循环(博客园 iTech 拆解)。
核心机制(技术)
一个 git 仓库就是团队 AI 资产的事实源。 数据分三区(usage-guide):知识资产(skills/rules/docs/learnings)放共享 repo 的 main 分支;会话统计等报告类推到独立的 orphan 分支,不污染主分支;机器本地数据(config、搜索索引)放 ~/.teamai/。所有 git 写操作都在隔离 worktree 里执行,不会碰你的工作树、也会跳过业务仓库的 husky/lint-staged 这类 hooks。
协作闭环:push → MR 评审 → 自动 pull。 任何变更(新增 skill、修改 rule、删除 MCP)都走 teamai push 建分支开 MR,reviewer 审批合并后,其他成员的 AI 会话启动时由 SessionStart hook 自动拉取分发——不需要谁喊一声「大家更新一下」(README)。分发粒度可控制:roles 让新人只拉 skills/backend/,tags 按标签订阅,source 还能订阅其他团队的公开 skill 仓库。
最有想象力的部分是经验自动回流。 会话结束时 Stop hook 会按「摩擦信号」打分:你是不是打断纠正了 AI、拒绝了某次工具调用、某个工具反复重试出错——「又长又顺的会话不会触发」,只有真踩坑的会话才提示你把经验总结成 learning 推到团队仓库(走 MR,每会话至多提示一次,可关)(README)。learning 不是直接变资产,有明确晋升门槛:confidence ≥ 0.90、至少 5 个 upvote、至少 2 个不同贡献者、入库满 14 天,满足后才 promote 为正式 skill/rule/doc(usage-guide)。配合 recall 召回(BM25 + 代码图谱加权重排,默认关闭)、maintenance 剪枝和 digest 周报(token 用量、会话量、干预率),构成一条完整的「沉淀 → 审核 → 召回 → 晋升 → 治理」生命周期。
工程质量值得一提:src/ 12 万行 TypeScript 里测试占 48%,单测 + e2e 双套,4.5 个月 695 commits、日均 5+,周级发版(GitHub API、contributors API)。但贡献者 34 人中第一名占了 534/695 commits(77%)——本质上是「腾讯一个小团队 + 1 个核心作者」驱动的项目,bus factor 不低。
横向对比(各家官方文档):Claude Code 的官方团队共享是把 .claude/skills/ 提交进版本控制 + 插件市场 + 企业 managed settings,绑定 Claude 生态(Skills 文档);Cursor 是 .cursor/rules 提交 git + Team/Enterprise 的云端 Team Rules,只管 Cursor(Rules 文档);Copilot 走组织指令 + 知识索引,绑定 GitHub。这些机制都只覆盖 teamai-cli 闭环的一小段,且都限定自家生态——跨 agent 中立 + git 控制面 + 经验回流闭环,是它的差异化所在。
怎么跑起来(环境)
- 安装:
npm install -g teamai-cli,前置 Node.js ≥ 20 + Git。纯本地 CLI,没有必需服务端,dashboard 也是本地起的(localhost:3721)(usage-guide)。 - 私有化:共享仓库可以放 GitHub、GitLab、GitCode、CNB、TGit 或任意私有 Git 服务,官方未提任何遥测或云依赖——仓库放内网 Git 就能全链路私有化,数据不出内网(usage-guide)。⚠️ 一个需要如实呈现的矛盾:README 列了 GitLab 支持且源码里有 gitlab provider 目录,但 zhangferry 实测称目前完整支持的只有 GitHub/TGit/CNB,自建 GitLab/Gitea 要等 issue #300——用 GitLab 的团队引入前务必先实测(zhangferry 评测)。
- 成本:teamai-cli 本体 $0(MIT,无任何定价)。真实成本在底层 agent 订阅:Claude Team $25/席/月(年付 $20)(claude.com/pricing),CodeBuddy Pro $10/月、Team $40/席/月(CodeBuddy 定价)。10 人团队主流档 $100–400/月,全走免费档也可以是 $0。
- 平台:CI 只测 ubuntu 和 macos(ci.yml),macOS/Linux 可直接用;Windows 没有官方背书,有 Windows 成员先 PoC。
数据说话(评测)
- 热度是新爆发的:star 2,979 / fork 185(2026-09-10),三周内 389(8/20)→ 695(8/30)→ 2979(9/10),涨了 7.6 倍(GitHub API、zhangferry、博客园)。
- 但围观多、装机少:npm 周下载仅 1,315(npm downloads);HN 两个提交帖都是 3 分 0 评论,V2EX 无帖(HN)——传播主要靠中文科技媒体和腾讯官方渠道。
- 口碑是「文档级好评」:目前所有评测文章都基于 README/文档分析,没有找到一篇生产环境的长期实测复盘。批判最力的 zhangferry 也认可理念(Git-native 分发、评审闸门、recall 默认关闭的克制设计),但明确判断「它还不到四个月大,远谈不上成熟」「方向正确、仍在快速长大的系统」(zhangferry 评测)。issue 区倒是有真实外部用户在报细粒度 bug 且被快速修复,维护响应很快。
- 落地案例:没有找到可核实的生产级案例。「腾讯内部 2026 年 3 月起使用」只有官方推文和媒体转述,README 里没有这个表述;侧面证据是支持矩阵里有腾讯内部 agent WorkBuddy(53AI)。
- 风险清单(引入前必读):① MCP 密钥在 pull 时解析为明文落盘本地配置,密钥管理严格的团队「这可能不是提醒,而是否决项」(zhangferry);② 0.x 阶段周级发版,API 快速变动(0.23.0 连顶层命令都改过名);③ Context/Improvement 两层官方自标 beta;④ 配置写错会经 pull 扩散到全队,MR 评审是唯一闸门;⑤ License 因腾讯前置声明格式被 GitHub 识别为 NOASSERTION,实质是 MIT 但自动扫描流程要额外处理;⑥ Session Autonomy 排行榜别拿去考核个人——干预多可能是 harness 有缺口,也可能只是这个人接了更难的活(53AI、zhangferry)。
值不值得跟(团队 leader 决策指南)
如果你是团队 leader,关心的是那四个问题,这里直接给答案。
用法(半天能跑通)。 管理员在 git 平台建一个共享仓库(或直接从 teamai-hub 模板起步,内置成套 skills/rules/review agents),执行 teamai init <repo-url>;成员进入项目目录同样 teamai init 接入(--scope user 可装到 ~/ 跨项目生效)。之后所有变更走 MR、更新自动 pull,teamai status 看差异、digest 看周报、dashboard 看知识库健康度(README、usage-guide)。
引入后的成果。 团队的 prompt、skill、rule、MCP 配置、hooks、协作文化(culture.md)全部 git 化——可版本回溯、可审计、新人 clone 即得全套 AI harness;踩坑经验由摩擦信号自动触发回流,经评审晋升为正式资产;MCP「声明一次,自动转成每个工具的 native 格式」;digest/dashboard 给你干预率、token 用量、知识库覆盖率这些以前根本拿不到的度量(博客园 iTech)。iTech 的判断是「7 天内就应该能拿到真收益」——这是文档分析结论,不是实测。
是否建议使用?分情况,这是社区两篇最深评测的一致画像:
- ✅ 适合:成员混用多种 AI agent、10 人以上、已经有人积累了个人 skill/prompt 实践、被「同一个坑不同人反复踩」困扰、且有明确的 owner 愿意管这个仓库。博客园 iTech 的原话是「teamai-cli 解决的是一个团队规模到 10 人以上才会遇到的问题」(博客园)。
- ❌ 先别上:单工具小团队——五个人都用 Claude Code,把
.claude/提交进仓库加官方 marketplace 就够了;以及连基本 rules 都没有的团队,zhangferry 说得扎心:「工具解决的是管道,管道里得先有水」,没有 owner 的知识库「只会从散落各处,迁移到另一个坟场」(zhangferry)。
如何使用(分阶段路线,别一步到位)。 社区共识的节奏:第 0 步花 10 分钟——只同步 5-10 条 rules,先验证「改一处、全员生效」这个最小闭环;第 1 周——迁 skills/hooks/MCP,同时装上治理闸门(sharing.hooks.autoApply: false、requireTeamScripts: true、紧急开关 TEAMAI_HOOKS_DISABLED=1);第 2-4 周——再开 recall,zhangferry 的警告值得抄在这里:「知识还稀的时候,全员开启 recall 带来的往往是 token 账单,不是帮助」;第 2 个月起——看 digest 趋势做剪枝,第一个月当基线期,「不要急着宣布提效」(zhangferry)。推广用 champion 模式:先让 2-3 名核心成员试装、doctor 验证全绿,再铺开到全队(博客园 iTech)。
一句话收束:方向正确、工程扎实、闭环完整,但它只有四个月大、还没被生产环境验证过——把它当一个值得小范围试点的方向,而不是全公司铺开的标准答案。
参考阅读
- GitHub README 中文版 — 定位、三层架构、兼容矩阵,第一手真源
- docs/usage-guide.md — 1559 行官方手册:数据分区、晋升门槛、治理开关
- zhangferry:团队AI协作的下一步,是让经验流动起来 — 批判最深的一篇:安全红线、适用画像、分阶段路线
- 博客园 iTech:腾讯开源 teamai-cli 深度拆解 — 工程视角 + 6 步试点清单
- 53AI 报道 — 谨慎乐观视角的缺点清单
- Claude Code Skills 文档 — 对照组:官方团队共享机制
- Cursor Rules 文档 — 对照组:双轨规则共享
- GitHub Copilot 组织自定义指令 — 对照组:组织级指令与知识索引