每日文摘
深挖 · awesome-gpt-image-2:30.1k star 的 GPT-Image 2 提示词模板库,最值得偷的是「三段式协议」而非架构图模板
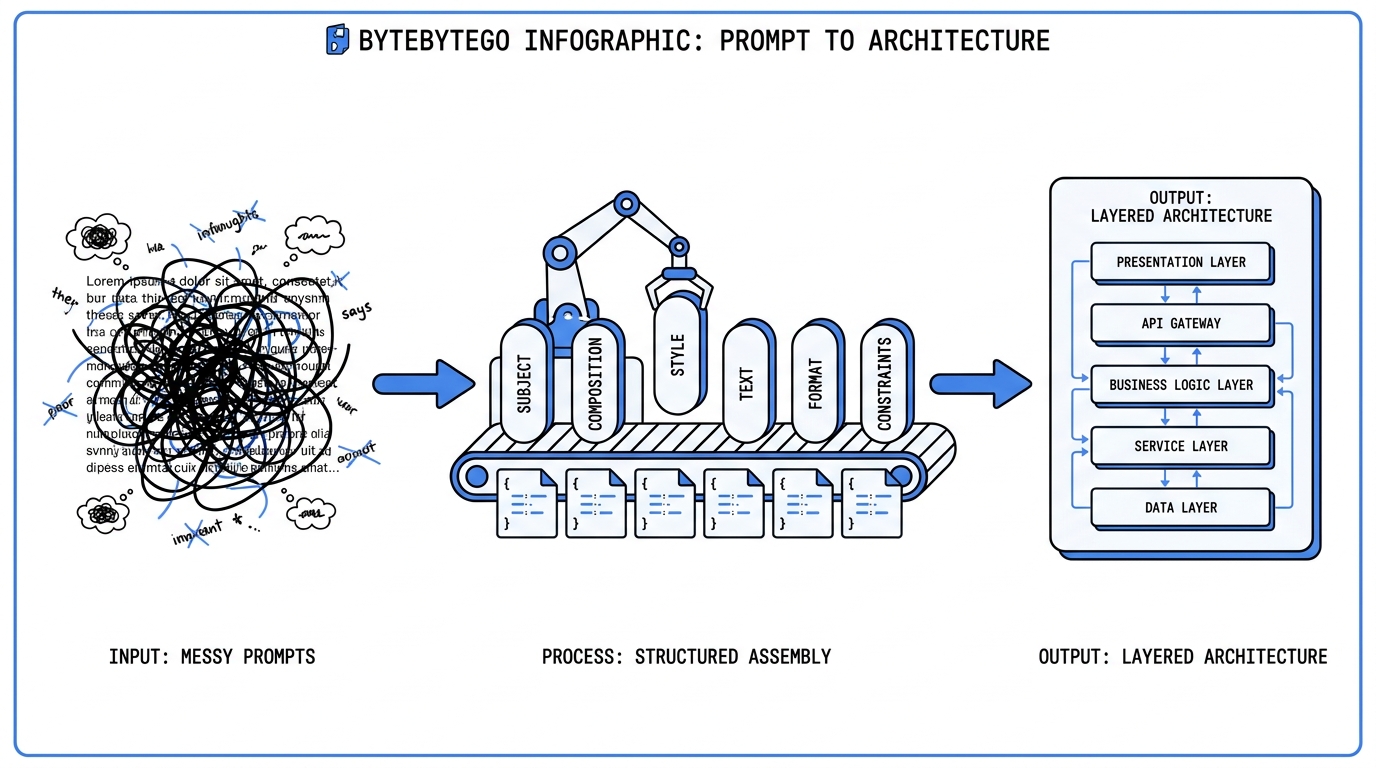
如果你也想让 AI 画出 ByteByteGo 那种架构图/流程图/示意信息图,大概率刷到过这个仓库:苍何(freestylefly)在 GPT-Image 2 发布后第 4 天创建的提示词模板库,4 个多月攒到 30.1k star。它把 541 条社区案例逆向成 20 多套结构化模板,号称「Prompt as Code」。这篇深挖回答一个问题:对「用 AI 画软件架构图」这个需求,它能给你什么——答案是一个能偷走的提示词协议,和一个必须先知道的反直觉真相。
是什么
仓库创建于 2026-04-25(模型 4 月 21 日发布后的第 4 天),170 commits,最近一次推送在调研前一天(2026-09-09),持续活跃(GitHub API)。它不是纯 awesome list,而是「文档库 + 数据 + 网站 + Agent Skill」四位一体:
- 文档库:
docs/templates.md(21 套模板)+ gallery 三册(541 个案例,每个带效果图、来源、完整提示词) - 数据:
data/cases.json541 条结构化案例(14 个字段,提示词长度中位数 1,044 字符),是全仓唯一真源 - 网站:配套站 gpt-image2.canghe.ai 整站开源(Vercel + Supabase + Stripe/支付宝,MIT 可 fork)
- Agent Skill:npm 包
gpt-image-2-style-library,可装进 Claude Code/Codex
13 个分类里与本文主题相关的是 Charts & Infographics(53 例,定义为「信息图、知识图谱、技术解释与结构化图解」)。一个先泼冷水的细节:仓库没有软件架构图专类——tpl-architecture 分类指的是实体建筑与空间;对 README、templates、gallery 三份主文件 grep,“ByteByteGo” 零命中。
另一个值得知道的细节是数字口径漂移:README 写 544 案例,cases.json 里是 541,社区 PR #29 修复索引后实测可达 535(18 例不可达、5 例重复、7/13 分类计数不符),templates.md 开篇还留着早期「393 个案例」的旧文案。勤奋的个人项目,不是严格工程——这不影响它的方法论价值,但引用数字时要留心。
核心机制(技术)
Prompt as Code:把散文压成协议
README 的 Project Vision 说得很直白:GPT-Image 2 时代的问题从「能不能生成图」变成「能不能稳定、可控、可复用地生成图」,这个项目把散落的社区案例变成 agent 和自动化工作流可复用的资产——核心是「把散文式提示词压缩成结构化协议」,原子 schema 把主体、光线、材质、布局、视觉细节拆成可组合的部件。
落地形态是三段式模板(以图表与信息可视化类为例):
- 常规模板(中文方括号填空,人用):主题/受众 → 结构(3–5 个模块、每模块图标+短标题+1–2 句说明、模块间箭头/连线)→ 图表类型 → 风格/主色/背景 → 输出
- JSON 进阶模板(英文键名,标注「推荐给 Agent 调用」):把 modules 拆成结构化数组,constraints 固化为
"No cyberpunk, no gibberish text, strict structural layout" - 避坑指南(负面约束沉淀):两条关键原文——「强制定制模块数量和图表类型,能极大降低画面混乱和信息溢出」「千万不要把大段正文塞进画面里,模型不是排版工人」
Agent Skill 的运行时规则把它进一步固化成六段式组装:主体任务 / 构图布局 / 风格材质 / 文字标注 / 画幅格式 / 约束负向(SKILL.md);批量生成的复用规则是「锁模板,只换 subject/composition/palette/scene 四个变量」——这正是「风格冻结、换主体生图」的工程化表达。
技术解释图的提示词范式(可直接偷)
53 个信息图案例里,对画架构/说明图最有参考价值的是三个范本(gallery):
- Case 1(工程白皮书风信息图):一段式英文提示词,结构 = 画幅+命名 → 内容枚举 → 12 个编号双语分栏 → 底部时间线 → 风格锁定(
engineering white paper + scientific atlas, light paper bg, crisp lines)→ 负面约束(No cyberpunk, no gibberish text)→ 空间硬约束(must show both above AND below ground) - Case 407(系统信息图):
Visual Direction → Main Subject → callout 标注清单 + Modules 模块清单双列表结构——把「图上要标什么」逐条写死,这是对结构化说明图最值得抄的写法 - Case 17(9 层爆炸拆解图):JSON +
{argument name="..." default="..."}参数化模板,左右 callout 文案结构化——可直接平移为「系统分层图:客户端层/网关层/服务层/数据层 + 层间箭头 + 组件标注」
汇总成一个可复用的四件套协议:身份定义(“not a poster, but a structured technical explainer”,先声明这不是海报)→ 结构规格(比例、模块数、callout 清单、数据流箭头)→ 风格锁定(white paper / flat vector 等)→ 负面约束(no gibberish text、禁塞长文)。
还有一个反直觉发现:Case 334「RAG 技术详解图」的完整提示词只有一句话——「帮我生成一张 RAG 技术的详细讲解图」(gallery-part-2)。同类的还有「可爱地解释一下大语言模型训练过程」。也就是说 GPT-Image 2 对技术讲解图有一句话出图能力,长提示词的边际价值在版式控制而非能力激发——日常迭代可以先一句话起稿,满意后再固化成长模板。
怎么跑起来(环境)
模型:GPT-Image 2 是 OpenAI 2026-04-21 随 ChatGPT Images 2.0 发布的图像模型,官方称首个带原生推理(thinking)能力,支持 2K 分辨率、多图生成,重点改进文字渲染与多语言。后继代 GPT-Image 2.5 在 9 月 8 日(调研前两天)发布,分 flare(快、延迟低 50%)和 sunburst(最强)两个变体,费率与 2 代持平;README 里的「2.5 Spotlight」只是作者用原提示词重生成 4 个案例的演示页,不是新功能。
调用与价格:官方 POST /v1/images/generations,token 计费图像输出 $30/1M token(上一代是 $40),Batch 半价(定价页)。官方没公布按张价目表,第三方换算 1024×1024 约 low $0.006 / medium $0.04–0.05 / high $0.17–0.21(WaveSpeed,口径未标明仅作量级参考)。仓库赞助商 APIMart 挂牌 $0.006/张(异步接口),hiapi 新用户送 $1 额度——都是 affiliate 转售,非官方。
在自有管线落地:GPT-Image 全系闭源 API-only,本地 3090 跑不了。好消息是任何 OpenAI 兼容的生图客户端(比如本站 pipeline 的 imagegen 脚本)与官方 endpoint 同构,改配置指向官方或可靠中转、加 Bearer 头即可。消费这个模板库不需要装 agent skill——直接读仓库里的 data/style-library.json(网站与 skill 共享的同一份数据源)挑模板拼提示词就行。
数据说话(评测)
模型本身在「图内文字 + 结构化信息图」场景是第一梯队:
- Artificial Analysis 文生图盲测榜:GPT Image 2 Elo 1171 排第 1(Nano Banana 2 1122、Seedream 5.0 Pro 1080、FLUX.2[max] 1026、Midjourney v7 897);但图像编辑榜第 3(1114),已被微软 MAI-Image-2.6(1124)反超
- 302.AI 八场景实测:对 Nano Banana 2 8:0 全胜(双语长文杂志差距最大),对 Seedream 5.0 Pro 5:1——竞品在中文信息图、UI 截图场景均出现乱码或排版断裂
折扣也要如实说:主要实测来源(302.AI、火山引擎社区、老张AI)都是 API 转售商,有商业动机;流传的「99%+ 中文排版准确率」查无独立出处(最早见于转售商软文,无测量方法);仓库 issue #36 有用户用相同提示词复现出现乱码,至今 0 回复;OpenAI 官方 cookbook 也承认图内文字要靠技巧(文字加引号或全大写、生僻词逐字母拼写、密集标签用 quality=high)。
star 含金量:无刷星指控也无审计反证。作者在知乎复盘里披露了起量流水线——Codex + Browser Use 全自动检索近 24h 带提示词的 X 帖、下载、提取、归类、部署,外加公众号/知乎双渠道导流(文内直接求 star)。这个赛道有 314 个同类仓库、头部四库全部建于模型发布前后一周内,素材高度同源(案例来源 YouMind 官方库自己就有 2000+ 条),本库的优势在工程化包装与中文渠道,不在素材独占。
图像模型画架构图,真相是什么
这是本文最重要的部分,来自调研中一个独立维度的交叉验证。
纯提示词直出 ByteByteGo 级架构图,当前不可靠。 失败模式有多方交叉证据(Lana Zhang 的 Nano Banana 2 实验、EdrawMax 教程、FigPad 指南):
- 连线与逻辑错误:双向箭头画成单向、组件缺失错位、标签含糊——「看起来漂亮但技术准确性不达标」
- 组件数量上限:40+ 组件的架构最多稳定呈现约 30 个
- 迭代不可复现:约 10 轮迭代仍难达精度要求,改一处牵动整图
- 产物是位图:API 只输出 PNG/JPEG/WebP,不可编辑、不可 diff、不能局部改
- 一次成功率低,中文乱码风险始终存在
社区三方独立收敛出的正解是混合流:先用 draw.io/Excalidraw(或任何结构化工具)做出正确性有保证的蓝图,再让图像模型只做视觉风格化重绘(手绘风、doodle、宣传感)。「技术正确性与视觉创意各归其位」。顺带一提,ByteByteGo 本尊官方路线也是 diagram-as-code(Python 画云架构),官方指南通篇未提图像生成模型。
图像模型占优的场景依然真实存在:模块 ≤5、短文案、白底扁平的科普 explainer(OpenAI cookbook 自己就把 infographics 列为正式用例)、面向大众的信息图、不要求精确可维护的一次性视觉表达。
如果你要找现成的「ByteByteGo 风格」提示词,目前最接近的是 Sweet Prompt 的 Knowledge Architecture Design System:白底极浅网格、黑白基底+蓝紫渐变胶囊、10 个细边框模块按 3+3+4 分层、闭环箭头表数据流、全文 1,621 词含负向提示——免费,可直接拆用。ByteByteGo 风格的构成要素拆解:白底/极浅网格、黑白主体+单点彩色强调、模块化矩形+胶囊标签、闭环箭头、模块数压在 10 以内、文案全短句;签名特征是流动虚线连线(draw.io 里勾选 Flow Animation 即可复刻)。
值不值得跟
对「用 AI 画软件架构图」的需求,这个仓库的净收益是三样:
- 三段式提示词协议(身份定义 → 结构规格 → 风格锁定 → 负面约束):可直接并入自己的提示词推导流程,比「一句大白话」稳定得多
- 避坑经验:模块 3–5 个的硬约束、文案克制(短句标签不塞正文)、no gibberish text、密集标签场景 quality=high——这些是用 500+ 案例换来的负面知识,比正面模板更值钱
- JSON 模板 + 变量锁定的批量机制:锁模板、只换 subject/composition/palette/scene,适合系列化出图保持风格一致
工作流建议:日常快速迭代用一句话起稿(Case 334 证明可行),满意后固化成长模板入库;架构图本体走混合流——结构正确性交给代码(draw.io、diagram-as-code、或让 LLM 手写 SVG),图像模型只做风格化层。一个必要的提醒:仓库里的效果图都是作者挑选发布的成功样本,issue #36 的乱码复现说明成功率要自己验,别把画廊当承诺。
参考阅读
- freestylefly/awesome-gpt-image-2 — 模板真源 docs/templates.md + data/style-library.json
- Introducing ChatGPT Images 2.0(OpenAI) — 模型官方定位:文字渲染/多语言/原生推理
- OpenAI cookbook: image-gen-models-prompting-guide — 图内文字技巧的官方口径
- 302.AI Benchmark Lab: GPT Image 2 — 8:0 横评实测与弱点清单(注意转售商背景)
- Artificial Analysis Text-to-Image Leaderboard — Elo 1171 盲测榜
- Generating Technical Diagrams with Nano Banana 2(Lana Zhang) — 图像模型画架构图最系统的单篇实验,「蓝图+重绘」混合流结论
- 12 天 4.2K Star 复盘(苍何) — Codex+Browser Use 自动抓 X 流水线的一手披露
- Sweet Prompt: Knowledge Architecture Design System — 目前最接近 ByteByteGo 风格的现成提示词