每日文摘
深挖 · TOML vs JSON:「LLM 交互转向 TOML」查无此趋势,TOML 真实地盘在配置层
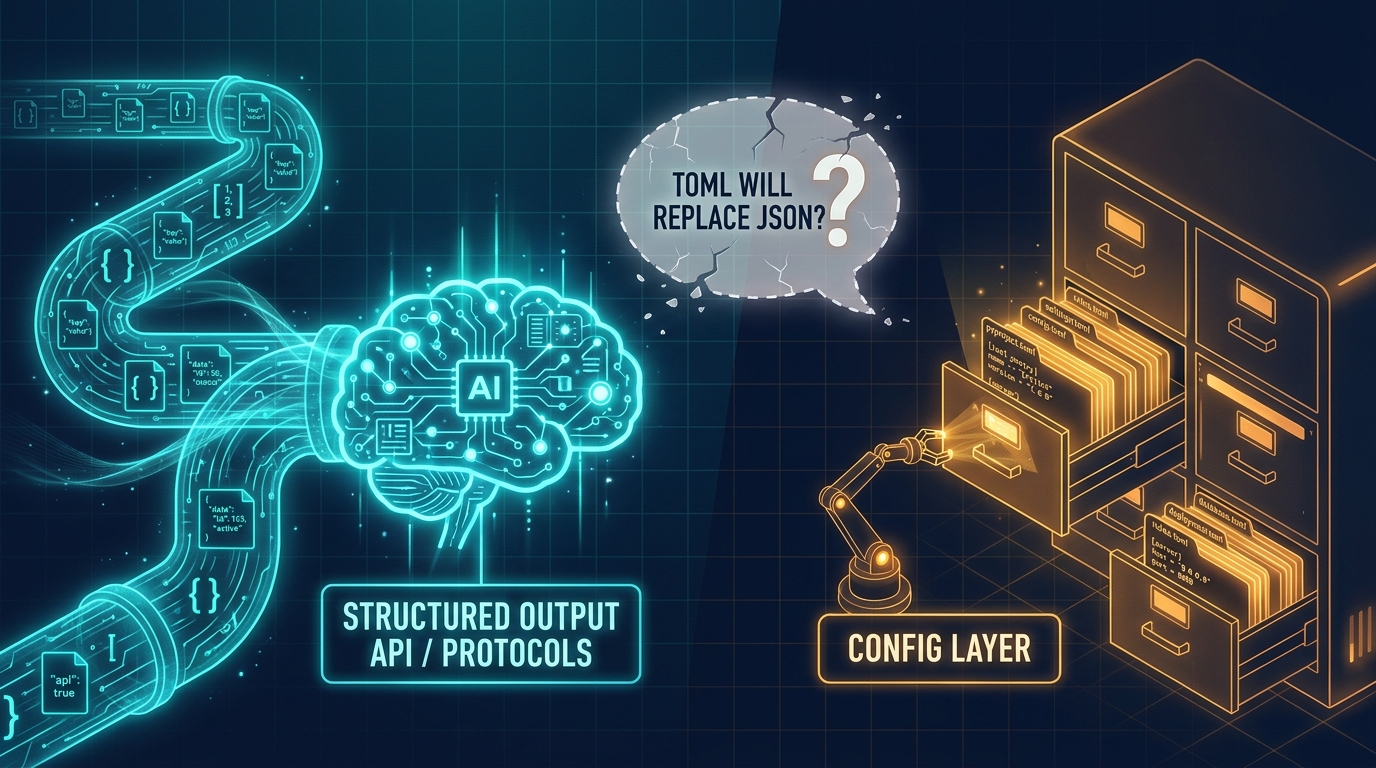
最近有一种说法在流传:「未来 AI 的内容交互可能更多会用 TOML,而不是 JSON」。听起来很顺耳——TOML 能写注释、人读舒服,JSON 花括号满天飞。但一个说法顺耳不等于它是趋势。这次深挖把该找的证据都找了一遍:出处、数据、基准、大厂文档、社区正反声音。结论先放在这:这不是业界趋势。它找不到可溯源的出处,找不到一条支持性实测,唯一的学术基准给出的是反向数据。而 TOML 在 AI 生态里的真实地盘,在配置文件那一侧。
一、先说结论:查无此趋势
判断一个「趋势」是真是假,最直接的办法是找它的出处。结果是:多组定向检索(“TOML instead of JSON LLM”、“TOML replace JSON 2026”、“prefer TOML” 等)都没能找到主张「LLM 交互转向 TOML」的著名文章、HN 主帖或广为流传的推文。能找到的最早痕迹,是 2023 年 5 月一条 HN 评论里的顺口一句「I found that LLMs are pretty good with TOML」——轶事,无数据。
这个话题里传播最广的格式对比文(David Gilbertson,用 gpt-4o-mini 实测六种格式)明确不主张 TOML:它实测后推荐的是 TSV,理由包括 TOML 所有字符串都要引号导致 token 偏高、不支持顶级数组。
厂商侧的证据更一边倒。截至今天(2026-09-06)查证:
- OpenAI Structured Outputs:只有
json_schema和json_object两种格式选项 - Anthropic:schema 走 JSON Schema(其底层其实有通用 grammar 引擎,但产品面只暴露 JSON)
- Google Gemini:只支持 JSON Schema 的一个子集
- Ollama、LangChain、instructor:同样全线 JSON-only
一个侧证:LLM 工具链最有影响力的博客之一 Simon Willison,站内搜 “TOML” 出来的全是 Python 打包语境(pyproject.toml、uv.lock),没有一篇讨论 TOML 用于 LLM 结构化输出。
有意思的是,「替代 JSON」的讨论本身是真实存在的,只是主角从来不是 TOML:TSV(Gilbertson)、YAML(ImprovingAgents 实测中 YAML 在 2/3 的小模型上胜过 JSON)、Markdown(省 34-38% token)、代码 DSL、新造格式 TOON/ISON。第三方实测者们做格式横评时,普遍压根没把 TOML 列为候选。
所以这个说法的合理内核其实是两件事被缝在了一起:TOML 在 AI 工程的配置文件侧确实在涨;「JSON 对 LLM 不一定最优」的讨论确实存在且有数据。但把这两件事合成「AI 内容交互将转向 TOML」——没有任何证据支持。
二、技术账:TOML 两个输一个赢
生成可靠性:最重的一票,TOML 输得很难看
StructEval(arXiv 2505.20139,18 种格式 × 44 类任务、12 个模型)是目前唯一把 TOML 纳入的学术基准,结论对 TOML 相当不利:Text→JSON 已饱和(得分 >0.95),而 Text→TOML 是全模型最难的任务之一。开源模型在 TOML 生成上平均只有 8.58%——Phi-3-mini 得 0.00,Llama-3.1-8B 得 6.76,Qwen3-4B 得 7.44。商用模型好一些(89-91 分),但仍全面低于自己的 JSON 成绩(92-99)。
工业侧同向。NVIDIA NeMo 团队实测:TOML 是最难生成的格式,「even GPT-OSS-20B only reaches 94%, and smaller models struggle below 30%」。他们用合成数据专门训练 Nemotron Nano v3 之后,TOML 成绩也只从 19.2% 提到 28.4%。
但这份论文里藏着一个对 TOML 公平的关键事实:TOML→JSON 转换任务多个模型拿满分 100。也就是说 LLM 读 TOML 毫无问题,崩的是写。原因也好理解——训练数据里 JSON 的量级远大于 TOML,模型对 JSON 的「肌肉记忆」是海量语料喂出来的,约束解码生态(JSON Schema)又全押在 JSON 上。
争议也要如实呈现:HN 的 TOON 讨论帖里有正方观点认为 TOML 在训练数据中「足够常见」,模型处理它相对可靠;但反方(也是社区主流)的论据正是训练分布——Structured Outputs Handbook 帖里的原话是「TOML isn’t widely adopted」。StructEval 的数据站在反方这边。
token 效率:只赢 pretty JSON,输给 minified JSON
token 账算下来 TOML 并不占便宜。OpenAI 社区实测同一份数据:JSON 13,869 tokens,转成 TOML 是 12,503——省约 10%。但这个对比的对象是带缩进换行的 pretty JSON。而 JSON 的空白是可选的:另一篇实测里 minified JSON 只要 41 tokens,pretty JSON 要 101,YAML 要 133——minified JSON 比谁 都省,因为 TOML/YAML 靠换行和结构承载语义,没法同等压缩。
本次调研本地用 tiktoken(o200k_base 与 cl100k_base 双 tokenizer)验证过同方向:TOML 比 pretty JSON 省 15-23%,但比 minified JSON 反多 8-19%。顺便排除了一个常见误解:BPE 下 TOML 的 =、[、] 等语法字符都是单 token,tokenizer 没有「针对」TOML——差距纯粹来自引号数量和空白结构。
表达能力与解析生态
TOML 有几个对「LLM 输出格式」角色很致命的硬伤:没有 null 类型、不支持顶级数组(你没法让 LLM 直接输出一条记录列表)、深嵌套要逐段 [[header]] 写得很痛苦。解析侧,toml-test 测试套件的存在本身就说明各语言 TOML 实现之间有分歧(整数位宽、精度、嵌套深度都留给实现裁量);而 JSON 是 RFC 8259 单一严格标准,配合约束解码可以保证语法 100% 合法。
定位问题也不能忽略:TOML 官网的自我介绍从头到尾都是「A config file format for humans」——它从来没想当数据交换格式(v1.1.0 已于 2025-12-24 发布,维护活跃,但改动方向是配置人体工学)。JSON 官网的设计目标里则明确写着「easy for machines to parse and generate」。
三、场景账:TOML 的真实地盘与 JSON 的护城河
把 2025-2026 年 AI 生态的文件格式盘点一遍,图景非常清晰。
TOML 的地盘在配置层。 头部 AI 编程工具里唯一用 TOML 做主配置的是 OpenAI Codex CLI(config.toml + requirements.toml)。更大体量的场景是 Python/Rust 工具链本身:pyproject.toml、uv(uv.toml)、pytest 9.0 新增的 pytest.toml(优先级最高)、Cargo.toml。AI 编程时 LLM 确实高频读写这些文件——但这是编程任务的自然边界,不是「AI 内容交互协议」。
JSON 的护城河在协议层。 MCP 协议消息是 JSON-RPC 2.0(规范原文用 MUST);Claude Code(~/.claude.json、.mcp.json)、Cursor(mcp.json)、Gemini CLI(settings.json)、Zed 的 MCP 注册文件清一色 JSON;function calling 的工具参数是 JSON Schema;agent 间通信标准 A2A 选定 ProtoJSON,决策记录里连 TOML 备选项都没有。没有任何一层出现转向 TOML 的计划、RFC 或严肃提案。
LLM 直读层被 Markdown+YAML 和 XML 占着。 Agent Skills 是 YAML frontmatter + SKILL.md;Anthropic 官方在 prompt 指南里推荐 XML tags,理由是解析无歧义。
顺带澄清一个以讹传讹:网传「Manus 把 agent 配置从 JSON 迁到 YAML」——抓取原文核对后不成立,那篇文章谈的是 JSON 序列化 key 顺序不稳定会静默破坏 KV cache,建议是保持确定性序列化,不是换格式。格式谣言的传播链,大抵都是这么来的。
四、作为使用者,现在能做什么
输出侧:别换格式,换写法。 如果目标是省 token,Tensorlake 的量化横评(209 个抽取任务、四模型平均)给了最省事的答案:pretty JSON 4,545 tokens 换成 compact JSON 只要 3,081(省约 32%),准确率不降反升(69.7%→70.7%)。配合 JSON Schema 约束解码保证语法合法,大部分收益就到手了——不需要 TOML。
输入侧:TOML 是好选择。 「LLM 读 TOML 近满分」这个事实值得用起来:给 agent 读的配置文件、状态文件、prompt 素材,用 TOML 可以内嵌 # 注释(这本身就是给模型的说明)、人可审改。现成案例:novel-ralph-skill 的 state.toml(脚本写、模型每轮读)、Codex 的 config.toml。
实验侧:想自己验证的话。 用 prompt 要求 LLM 输出 TOML 是可行的(Terminal-Bench 已把「写出 output.toml」列为前沿模型的可测能力),但这是软约束、无保证。想要硬约束 TOML 输出,目前唯一的路是自托管 llama.cpp 自己写 GBNF grammar——官方 grammars 目录里没有现成的 toml.gbnf。程序侧接住 LLM 生成的 TOML 时注意生态分化:Rust 的 toml crate 是一等公民;Python 3.11+ 的 tomllib 内置但只读(写回要 tomli-w);JS 最主流的 @iarna/toml 已经 6 年没发新版。
观察侧:值得跟的真趋势。 「JSON 不最优」这条线上真正在发生的事:compact JSON 常规化、TOON 类 token 导向格式(比 pretty JSON 省 39.6%,但也有「格式太新不在训练集」的批评)、以及 Gilbertson 预测的「厂商未来会支持更多格式选项」。如果哪天 OpenAI 或 Anthropic 的 structured output 加了第二个格式选项,那才是趋势信号——到今天为止没有。
值不值得跟
不值得把 TOML 当作 AI 交互的未来去追。它是「个别人士的主张 + 格式多元化讨论的误传」,证据链上从出处、数据、基准到厂商支持全面缺位,且唯一的学术基准直接反向。值得做的反而是三件小事:输出用 compact JSON + Schema 约束(今天就有效)、给 LLM 读的配置状态文件大方用 TOML(扬长避短)、把注意力放在 token 优化这条真趋势线上。
参考阅读
- StructEval: Benchmarking LLMs’ Capabilities to Generate Structural Outputs — 唯一纳入 TOML 的学术基准,18 格式 × 44 任务,数据反向
- Structured Outputs from Nemotron (NVIDIA) — 工业实测:TOML 是最难生成的格式
- LLM Output Formats: Why JSON Costs More Than TSV — 传播最广的格式对比实测,明确不主张 TOML
- TOON vs JSON (Tensorlake) — compact JSON 省 32% 的量化出处
- TOML 官网 — 官方定位:配置文件格式,非数据交换
- MCP Specification — 协议层 JSON-RPC 2.0 的一手规范
- YAML vs JSON — The Minification Truth — 澄清 minified JSON 才是 token 效率基准线
- HN: LLM Structured Outputs Handbook 讨论帖 — 社区正反声音最集中的现场