每日文摘
深挖 · serena:给 coding agent 配上 IDE 引擎,28.8k star、40+ 语言,与 zg 一找一改正好互补
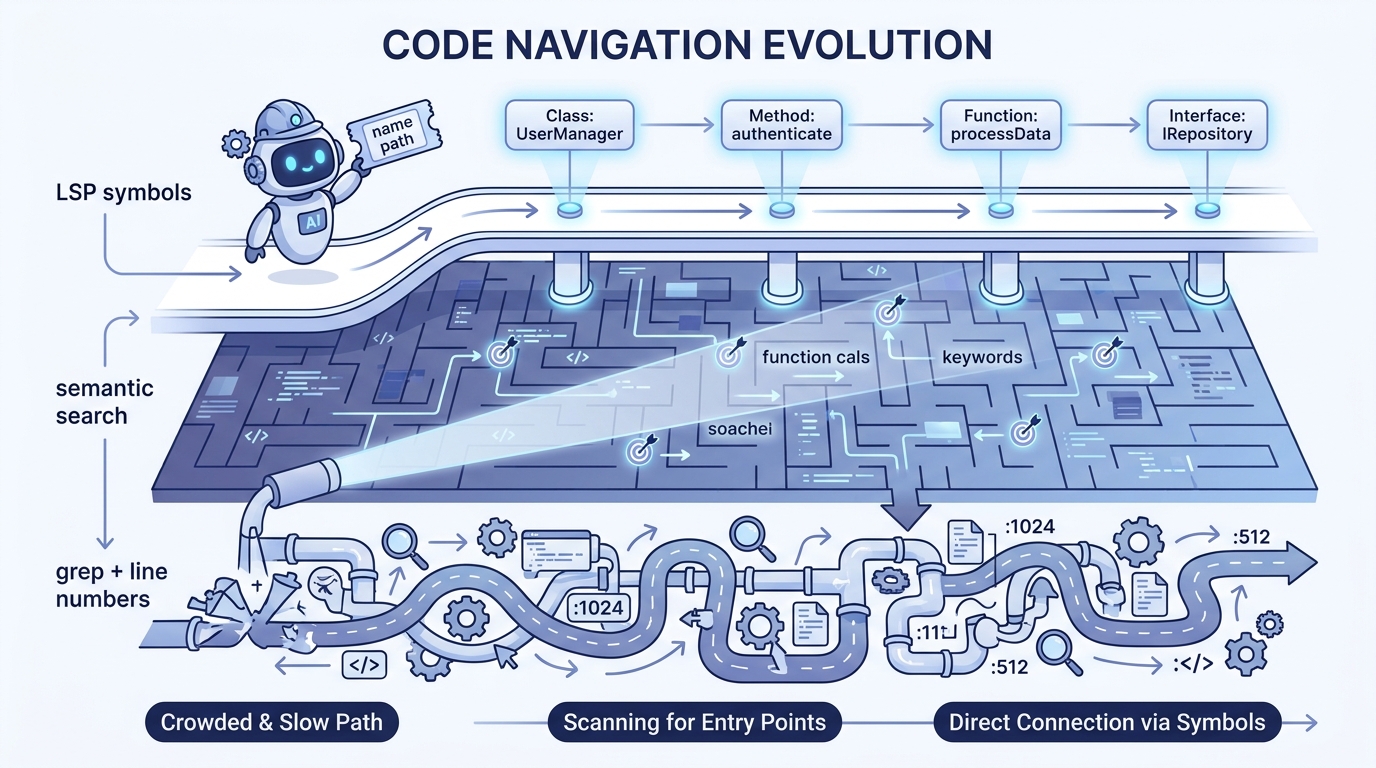
上一篇深挖的 zg(zvec-grep)解决的是「agent 找代码」的检索问题——语义、关键词、正则三路合一。找到之后呢?改名、挪函数、看谁引用了它,这些 IDE 里点一下的事,agent 还在用 grep 加行号硬啃。serena 就是来补这一层的:把语言服务器(LSP)包装成 MCP 工具交给 agent,自称「The IDE for Your Coding Agent」,28.8k star。它和 zg 是不是重复?拿来读开源项目学代码值不值?这篇按这几个问题展开。
是什么
serena 是德国公司 Oraios AI(2024 年成立)的开源项目,2025 年 3 月建仓,MIT 协议(注意:官方 discussions 已置顶公告 v2 拟转回 GPL,采用前值得跟踪条款),209 位贡献者,v1.7.0,调研当天仍有提交。它在 agent 和语言服务器之间做了一个抽象层:agent 通过 MCP 调用符号级工具,底层由 LSP 语言服务器解析出 AST 和符号表来干活——精确、结构化、语言原生。
双后端设计:免费默认的 LSP 后端,宣称支持 40+ 语言(成熟度分层:Python/TypeScript/Dart 零配置即用;Go/Rust/Java/C++ 需要手动装语言服务器;Erlang/Kotlin 等标注 experimental);付费的 JetBrains 插件后端($5/月)复用 IntelliJ 系 IDE 的语义引擎,独占跨文件 move、inline、交互式调试。
工具面共 38 个工具类:符号检索(find_symbol、get_symbols_overview 文件大纲、find_referencing_symbols、find_implementations)、符号级编辑(replace_symbol_body、rename_symbol、safe_delete_symbol)、Markdown 记忆系统、项目 onboarding、shell 执行。值得称赞的细节:在 Claude Code/Codex 这类 harness 里,与宿主自带能力重叠的基础工具(read_file、search_for_pattern 等)默认禁用,官方主动裁剪冗余。
核心机制:从「行号寻址」到「符号寻址」
用与不用 serena 的差异,根源在寻址方式。agent 的内建链路是正则匹配 + 行号/偏移寻址:grep 找到行号、read 按偏移读、edit 按行号改——文件里任何一次插入都会让之前的行号全部失效,只能重新 grep。serena 用 name path 寻址(如 CollectStats/refresh_return_stats),是结构性的:符号在哪一行无所谓,名字路径就是地址,编辑后天然稳定。
典型的检索组合拳:get_symbols_overview 先看文件大纲(只有符号签名,没有函数体),find_symbol 直取目标方法体,find_referencing_symbols 找全部引用并按 import/call/类型注解分类。官方评测里,后者返回 63 个纯代码文件、零误报;同样的任务 grep 返回 83 个文件——混进了 README、CHANGELOG 和 notebook。同名方法消歧更是结构寻址的天然主场:三个类各有 reset_env,name path 直接定位,grep 只能给三个行号再读上下文猜。
memories 系统值得一提:纯 Markdown 文件,项目记忆存 .serena/memories/(可以提交进 git、进 PR、回滚),全局记忆存 ~/.serena/memories/global/。设计上做渐进披露——agent 启动只拿到记忆文件名清单,内容按需读,大量笔记不会一次性灌满上下文。官方明确排除了向量库/数据库方案,理由是「词法或语义检索都同时产生假阳和假阴,name-based 的显式引用是确定性的」,自称最近似的既有形态是 Obsidian 这类 Markdown 知识库工具。
三条路线放在一起看就清楚了:
| 内建 grep/整读 | serena(LSP 符号级) | zg(向量+BM25+ripgrep) | |
|---|---|---|---|
| 原语 | 文本匹配 + 行号寻址 | AST/符号表 + name path 寻址 | embedding 相似度 + BM25 + 正则 |
| 强项 | 零索引、语言无关、非代码文件 | 精确定位、引用遍历、原子重构 | 不知道符号名时的意图发现 |
| 弱项 | 同名消歧、行号失效、跨文件重构要 8–12 步 | 受语言服务器质量约束、小改无收益 | 近似召回、无精确定位保证 |
用与不用,差异到底有多大
先给官方数字,再给泼冷水的——这部分的证据链特别能说明问题。
官方评测(Claude Opus 4.6 在 26K 行的 Tianshou 库上做 20 个任务,同任务双跑记调用次数和 payload):跨文件 rename(4 个文件)serena 1 次原子调用,内建工具要 1 次 Grep + 4 次 Read + 4 次 Edit 共 9 次;大改 payload 省 1.8–8 倍;但 1 行小改反过来,Edit 只发 120 字符、serena 要发整个方法体 550 字符,官方自己算出交叉点在「改动超过方法体一半」。注意官方评测的局限:agent 自评、规则被官方自认「可能隐性偏向 serena」、且全部用 JetBrains 付费后端跑——多数用户实际用的 LSP 后端根本没被评过。
最有分量的独立证据是法国电商 ManoMano 的三方基准(36,407 行 Java、381 类、1017 个测试,Sonnet 4.5):大重构任务 vanilla Claude 跑 1 小时花 $23.54 失败,Claude Code 内置 LSP 花 $28.63 三轮迭代后放弃,serena 45 分钟 $27.30 全部测试通过,团队宣布 must-have 并把 .serena 目录提交进仓库。但同一篇文章的反面数字:只读快查场景 serena 贵约 4 倍、慢 60%。他们的结论是「一刀切不成立,按任务选工具」。
学术侧更狠:arXiv 2608.13568 对生产级 LSP-MCP server 做五臂消融(不直接测 serena,测的是这个品类),定位任务 LSP 比 grep 多花 6%–118% token,而且 agent 即使 LSP 免费可用也只有 0–6% 的时间主动用它,结论原话「The answer is conditional and usually negative」。
最贴近真实的数据来自 serena 自己的 issue #1491:一位用户分析了 21 天、13 个仓库、21,089 次工具调用、192 个会话的 Claude Code 日志——只有 35.4% 的会话用过任何 serena 查询工具;全部读类操作中 serena 占 20.3%,内建 Read+Grep+Glob 占 79.7%;serena-only 会话为零。实践中的 serena 是混用的补充,不是替代。社区还有一个真实痛点:context 变长后模型会「漂移」回 Grep/Read 不用 serena,官方的办法是 hooks 每 60 秒注入提醒硬拉回来(#1201),而 hooks 本身也有误伤——连续读 Markdown 文档会被 nudge(#1398)。至于「Claude Code 已有原生 LSP,serena 过时了」的争论(2025-12 起真实存在),2026 年的社区对比和 ManoMano 实测都还认为原生 LSP 不成熟:坐标寻址多往返、同名方法混淆出幻觉。
和 zg 怎么配合:发现层 × 行动层
serena 官方讨论区里有个很好的分层判据(discussion #1885):「graph for orientation, LSP for anything you’re about to act on」——索引/图/检索类工具管定向,LSP 管你即将动手的东西。套到我们的工具箱:
- zg = 发现层:不知道符号叫什么、只有一句意图描述(「处理 AST 节点属性初始化的代码在哪」)→ 语义+BM25+正则混合检索找入口。zg 官方文档自己推荐的模式就是「semantic first,rg verify」。
- serena = 行动层:一旦知道符号名 →
find_symbol直取、find_referencing_symbols遍历引用、rename_symbol一次原子改全库。 - 内建工具 = 兜底层:1–3 行小改、自由文本搜索、配置文档 shell,官方和第三方都认为这里该用轻工具。
同挂一个 agent 的代价也清楚:zg 的 MCP 默认只注册 1 个工具(agent toolset,刻意「只暴露搜索」),full 模式也才 6 个——上下文增量几乎全在 serena 侧。混用的互补性有实证:#1491 的数据里 18.4% 的符号查询之后仍跟了一次对同一文件的整文件读(带 offset/limit 切片),模型拿到符号体后还想看「周围长什么样」——符号工具和文件读取天然互补,谁也不吃掉谁。两者的记忆/检索面也不冲突(zg 无记忆系统,serena memories 是 Markdown),不会出现「两个互不知道彼此存在的记忆库」那种同层重复的坑。
拿来学开源代码,值不值
先说实话:serena 官方 README 和文档没有把「学习陌生代码库」列为显式 use case,官方评测也是编码任务而非理解型任务。但对「反复回访同一个开源项目、跨会话积累理解」的学习流,它有两个 zg 没有的东西:
一是 onboarding:首次激活项目时自动摸底(结构、构建系统、测试设置),把项目知识写进 .serena/memories/,之后每次进入自动复用——第一次读懂的东西不用第二次重读。二是记忆即笔记:纯 Markdown、人可读可改、可进 git,和 Obsidian/Basic Memory 用户的工作流同构。dev.to 上的实战记录确认了省 token,但也提醒两件事:onboarding 本身会读大量文件吃满上下文(官方建议完成即开新会话),自动生成的 memories 有不准确处需要人工纠正。
边界也要知道:纯浏览式快查,zg/内建工具更省(ManoMano 那个贵 4 倍的数字就是只读场景);结构差的代码库(巨型 God class、面条函数)效果差——官方文档明说 serena 依赖代码结构,动态类型语言建议加类型标注。所以对学习场景的结论:要动手改、要追调用链、会反复回访的项目,serena 值得;走马观花看一遍的项目,zg 够了。
怎么跑起来:一次性配置 + 每项目三步
一次性全局配置(官方安装文档):
# 前置:uv(唯一依赖)
uv tool install -p 3.13 serena-agent   # Python 需 ≥3.11
serena init                             # 初始化(默认 LSP 后端)

# 接入 Claude Code(一键)
serena setup claude-code
# 接入 Codex
serena setup codex
两个坑提前说:官方明确警告不要从 MCP/plugin marketplace 安装(那里的命令过时);网上老教程流传的 --context foreground 参数在 serena 从未存在过(源码逐版本核实),正确姿势是 --context claude-code --project-from-cwd。可选 hooks(自动批准 serena 工具调用 + 60 秒未用注入提醒)在 .claude/settings.json 配置。
之后每个新项目只有三步一次性动作(官方 Workflow 文档):
- 激活:进项目目录启动 agent,
--project-from-cwd自动识别;没有项目会自动创建,语言按源文件自动检测(多语言时交互确认)。也可以serena project create --language python --index显式建。 - onboarding(仅首次):检测到没有项目记忆时自动执行,摸底项目写入 memories。吃满上下文,完成后开新会话,人工 review 一下生成的记忆。
- 索引(仅一次):
serena project index,之后文件变更自动增量更新(JetBrains 后端无需此步)。
三步之后日常零动作。.serena/project.yml 里可以调 language_servers(第一个是主语言)、ignored_paths、read_only(把 serena 变成纯只读检索工具,学习场景很实用);project.local.yml 放本地私有配置(默认不进 git);.serena 整个目录可提交进 git 团队共享。语言服务器获取:Python(Pyright)走 uvx 自动、TypeScript 走 npm 自动、版本全 pin;Go/Rust/Java/C++ 需要自己装(gopls/rust-analyzer/jdt.ls/clangd)。资源面:无 GPU 要求,社区实测每个实例约 2GB 内存(挂多个会话时注意);默认只听 localhost,遥测只有一次 GET 五个非代码字段,SERENA_USAGE_REPORTING=false 可关。
值不值得跟
给结论:serena 的甜区是「大 repo + 跨文件符号级重构 + 反复回访的项目」,官方数字(rename 1 次 vs 9 次)和 ManoMano 独立基准(唯一全过 1017 个测试的配置)都指向这里;快查、小改、文本任务它没收益甚至负收益,独立学术研究对整个 LSP-MCP 品类的 token 节省持否定态度,真实使用中它只占 read 操作的 20%——它是按任务选用的重型工具,不是全局常开的基础设施。与 zg 的配合关系清晰:zg 找入口,serena 动手改,内建兜杂活,同挂的上下文代价主要在 serena 一侧,可控。
风险清单:v2 转 GPL 的信号需要跟踪;Claude Code 原生 LSP 若成熟,serena 的独占价值会收窄;模型不用它的 context drift 问题靠 hooks 缓解但没根治。对我们(ZCode + Claude Code + Codex,Mac + Linux 自托管)的落地建议:先在 1–2 个长期维护的大 repo 上按任务试用(重构时开、快查时用 zg),把 .serena 提交进仓库积累项目记忆,跑一个月再决定是否进默认工作流。
参考阅读
- oraios/serena README — 定位、双后端、能力矩阵一手来源
- 官方评测:Claude Code on Tianshou — 官方量化数字与自认局限,最细的机制对比
- ManoMano Tech: Why Serena is Our New Must-Have — 最有分量的独立三方基准,正反数字都有
- arXiv 2608.13568: Does a Language Server Save Tokens for Coding Agents? — 品类级否定性学术证据,平衡官方叙事
- issue #1491: 21 天真实使用统计 — serena 与内建工具实际混用比例的唯一样本
- 官方文档:The Project Workflow — 每项目流程一手来源
- discussion #1885 — 「graph for orientation, LSP for action」分层判据
- 官方文档:Memories & Onboarding — 记忆系统设计哲学(为何排除向量库)