每日文摘
深挖 · crawl4ai:80.9k star 的爬虫,为 RAG 和 Agent 而生
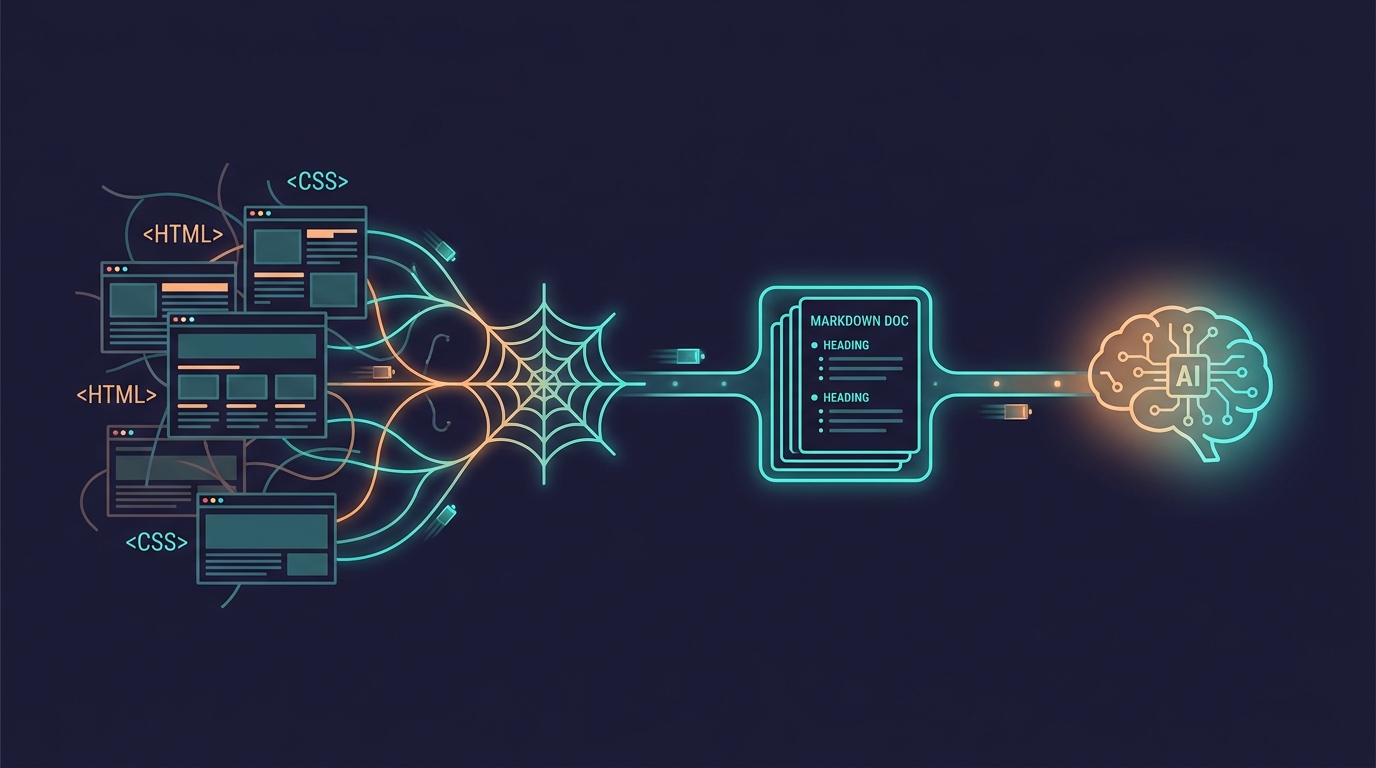
今天 GitHub Trending 上的 unclecode/crawl4ai 值得停下来细看:它不是「更好的 Scrapy」,而是给 RAG 和 AI Agent 造的爬虫——80.9k stars,GitHub 星标最多的爬虫项目。它试图回答一个传统爬虫从不关心的问题:不是「怎么把网页抓下来」,而是「抓到什么时候算够用」。这篇深挖它的机制、真实口碑和安全记录,帮你自己判断值不值得用。
是什么
如果你在 GitHub 上搜爬虫,排第一的不是 Scrapy 也不是任何老牌工具,而是 crawl4ai——80.9k stars、8.4k forks(GitHub API 2026-09-02 实时数据),号称 GitHub 星标最多的爬虫项目。它的定位一句话说清:把网页变成 LLM 直接可用的干净 Markdown 和 JSON,服务 RAG、AI Agent 和数据管道。
作者 unclecode 的动机写在 README 里:2023 年需要 web-to-Markdown 工具时,发现当时的「开源」选项要求注册账号、拿 API token、付 $16 月费,体验还不好——于是「turbo anger mode」,几天内写出 crawl4ai 并走红(README 自述,未点名竞品;$16 与 Firecrawl Hobby 档定价吻合,系推断)。
这个项目也代表了一个品类:「crawl for LLM」。RAG 和 Agent 需要的是干净 markdown、结构化 JSON 和可引用的来源,传统爬虫给的是原始 HTML——连 Firecrawl 的文档都明说「converts web pages into markdown, ideal for LLM applications」(Firecrawl docs)。这个品类目前三家并立:Firecrawl(175.3k★,AGPL,托管 API $16–599/月)、ScrapeGraphAI(30.3k★,MIT,LLM 驱动)、crawl4ai(80.9k★,Apache-2.0,库形态零门槛)(各家 GitHub README)。
核心机制
先说清它和普通爬虫到底差在哪。 传统栈是分层的:requests 管传输、BeautifulSoup 管解析、Playwright 管浏览器驱动、Scrapy 管工程化框架(scrapy.org、playwright.dev)——它们的输出都不是 LLM 就绪格式。crawl4ai 没有重造这些轮子,它落在 Playwright 之上的一层:LLM 内容加工层,整条管线对齐 RAG 工序。
具体拆开是四个机制:
1. Markdown 生成管线,而非 HTML 直出。 抓取后自动过两级过滤——PruningContentFilter 按文本/链接密度启发式去噪(约 50ms 开销),BM25ContentFilter 按你的查询保留相关块,两者可串联——再由 DefaultMarkdownGenerator 输出多形态:原始 markdown、降噪后的 fit markdown、链接转成 [text][1] 编号引用的 citation 版(喂 LLM 时不污染上下文)(markdown-generation.md)。
2. 提取双轨,确定性优先。 JsonCssExtractionStrategy 用 CSS/XPath schema 零 LLM 提取,官方文档称近即时,而 LLM 路径在大规模场景慢 10–1000x;更妙的是 generate_schema()——用 LLM 一次性生成 CSS schema,之后提取永久脱 LLM(no-llm-strategies.md)。LLM 提取(Pydantic schema + 自然语言指令,经 LiteLLM 兼容任意模型)只是可选项。这是它与 ScrapeGraphAI 的路线分歧:后者把 LLM 放在管线中枢,每次抽取都要过 LLM。
3. AdaptiveCrawler:按「信息够用了没」停止。 这是与 BFS/DFS 的本质分界。传统深爬按固定模式遍历,「抓完一切听天由命」;AdaptiveCrawler 每爬一页评估三个指标——Coverage(覆盖对的页面没)、Consistency(多源信息一致没)、Saturation(新页面还在贡献新信息没)——置信度到 0.7(默认)自主停止,每页只跟 3 个最优链接(adaptive-crawling.md)。查询完全不相关时(在 Python 文档站查菜谱)爬 2 页、置信度 5% 就放弃。两种策略:统计式(纯信息论,离线零依赖)和 embedding 式(默认本地 MiniLM,带查询变体扩展)。需要如实说明:官方文档未公布增益的数学公式,只有参数化阈值——宣传的「信息增益算法」细节低于预期。
4. 反检测一体化。 stealth 模式、undetected Chrome、三层反 bot 检测 + 代理自动升级、patchright 反检测驱动——这些在原生栈里都要自己拼装(README、pyproject.toml)。
怎么跑起来
安装极简:pip install -U crawl4ai && crawl4ai-setup(自动装 Playwright 浏览器),crawl4ai-doctor 体检,Python ≥3.10(installation.md)。四种部署形态按需选:
- pip 库:异步 API,任意 Python hook,自由度最高
- Docker server:端口 11235,自带 playground/dashboard/MCP,≥4GB RAM;注意 0.9.0 起强制配 API token(self-hosting.md)
crwlCLI:crwl https://example.com -o markdown一行出结果,甚至-q "这段代码讲了什么"直接问答- MCP 工具集:md/html/screenshot/execute_js/crawl/ask,Claude Code 一条命令接入
对自托管用户最关键的是成本结构:存在一条完全零 API 成本的路径——CSS 提取 + BM25 过滤 + 统计式自适应爬取全程离线免费;LLM 提取接本机 Ollama 写 provider="ollama/qwen2" 免 token(quickstart 官方示例)。crawl4ai 自身 CPU 就够(Docker 下限 4GB RAM),显存压力全在 Ollama 侧的模型。一个要知道的细节:核心依赖锁定 unclecode-litellm==1.81.13——上游 litellm 2026 年 3 月在 PyPI 被投毒隔离后,官方 fork 自保至今未切回(pyproject.toml)。
数据说话
先泼冷水:所有官方 benchmark 都是作者自测,无第三方复现。数字本身很漂亮——传统深爬 500 页/$15/2 小时 vs 自适应 15 页/$2/10 分钟;SaaS 文档站场景效率 8%→93%(1000 页降到 95 页,有用页反而从 80 涨到 88)(官方博客)。但调研中发现一个文案内部矛盾:客服知识库场景自称「93% 时间节省」,而其原始数字是 12 分钟 vs 18 小时——实际约 98.9%,对不上。量级可信,具体数字需打折。
社区口碑是另一面镜子:HN 上没有爆帖(最高 story 仅 7 分)。好评说它「模块化、不强绑 LLM」,是不少人的 daily essentials;差评也具体——有用户实测「crawl4ai 和 firecrawl 都穿不透 shadow DOM」(与 README 后来宣传的 flattening 存在时间差或场景差),还有人专门建了非官方文档站 crawl4ai.dev,理由是「新手搞不定生产配置」(HN)。
安全记录必须单独说。 4 个月内 10+ 条 GHSA 安全公告,其中 2 条 Critical(extra_args 注入 RCE、下载路径穿越 RCE);v0.9.3(2026-08-31,调研前一天发布)一次性修复 PDF 任意文件写入、SSRF、DoS、XSS 五项——官方自述根因是 PDF 抓取策略在浏览器外用 requests 直抓,绕过了出口控制的架构性遗漏(security advisories)。两面性也要讲:漏洞全是协调披露、外部报告人署名、修复附 22 个单测,流程规范。另有顽疾 issue:Docker 内存泄漏(#1256)open 超一年、Markdown 丢标题层级(#1964,直击核心卖点)。
横向对比的第三方数据很有限:唯一带数字的 crawl4ai.dev 对比(自述非官方且偏向 crawl4ai)显示 Firecrawl 延迟反而快 37%(100 个 JS 重页面 240s vs 380s),crawl4ai 胜在成本($0.15 vs $2.50/100 页自托管)。
值不值得跟
理念层面值得跟:「按信息充分性决定何时停」是真创新,直击 over-crawling/under-crawling 两难;确定性优先、LLM 可选的架构判断也比「万物皆 LLM」的路线清醒。Apache-2.0 + 零门槛 + 完整离线路径,对自托管场景很友好。
工程层面保持警惕:0.x 版本号、官方数字自吹自擂且内部矛盾、Docker 路径反复出安全问题、内存泄漏超一年未修。结论是——当库用,别当服务用:嵌入自己的脚本跑离线提取/自适应爬取,风险可控收益直接;长期常驻的 Docker server 形态目前不建议上生产,除非做好隔离和监控。
参考阅读
- crawl4ai README — 定位、功能全景与作者动机的一手自述
- Adaptive Crawling 官方文档 — 三指标算法、参数与双策略对比
- Adaptive Crawling Revolution 官方博客 — 全部对比数字的出处(vendor benchmark)
- self-hosting.md — Docker/token/MCP/Ollama 接入的一手部署文档
- commit 4e4a996 — litellm 供应链事件后 fork 的一手证据
- security advisories — GHSA 安全公告全史
- Crawl4AI vs Firecrawl(crawl4ai.dev) — 唯一带数字的第三方对比(自述非官方且偏向 crawl4ai)
- HN 搜索 crawl4ai — 社区真实口碑切片